Warning: package 'formatR' was built under R version 4.6.1Warning: package 'webexercises' was built under R version 4.6.1Warning: package 'formatR' was built under R version 4.6.1Warning: package 'webexercises' was built under R version 4.6.1This lesson brings together several ideas from previous topics: importing files, working with character strings, subsetting objects, plotting results and writing functions. The biological context makes the examples more interesting, but also more demanding: we need to be clear about what is a header, what is a sequence, what is a match, and what kind of object each package returns.
R8 is about using R to explore molecular biology data. We will start with simple plain-text operations on FASTA files and then move to sequence-aware tools such as seqinr, database queries with rentrez, sequence visualisation and Bioconductor.
The key distinction is:
grep() or sub() are useful for finding patterns in strings;seqinr or Bioconductor packages are useful for biological operations on sequence objects.Biological data, like protein or nucleic acid sequences can be stored and explored in different formats, each following its own structure. As you can imagine, that facilitates the use of regular expressions in any programming language to access that data. The use of regular expressions in R is similar to other languages, particularly, to the use you learnt in Python. Anyway, I suggest that you have a look to the References below.
Moreover, for advanced manipulation of string object, I’d advice the package Strings.
In the code below, we are going to use some simple regular expressions to explore and analyse the data in a multifasta file containing the whole proteome of the bacterium Bacillus thuringiensis HER1410 (HER1410.fasta) in our data folder, using grep(), substr(), sub(), and regexpr().
A FASTA file is a plain-text file. Each sequence usually starts with a header line beginning with >, followed by one or more lines containing the sequence.
>protein_id description
MKKLIA...
This is why a simple pattern such as ">" can be used to count or extract sequence headers.
#read the text file with readLines()
proteome <- readLines("data/HER1410.fasta")
#number of sequences in the multifasta using grep
length(grep(proteome, pattern=">"))
[1] 5807#extract recombinases
grep("recombinase", proteome,value=TRUE) [1] ">QKO37045.1 recombinase RecA (plasmid) [Bacillus thuringiensis]"
[2] ">QKO36998.1 recombinase family protein (plasmid) [Bacillus thuringiensis]"
[3] ">QKO36701.1 DDE-type integrase/transposase/recombinase (plasmid) [Bacillus thuringiensis]"
[4] ">QKO36696.1 tyrosine recombinase XerS (plasmid) [Bacillus thuringiensis]"
[5] ">QKO36060.1 tyrosine-type recombinase/integrase [Bacillus thuringiensis]"
[6] ">QKO36057.1 tyrosine-type recombinase/integrase [Bacillus thuringiensis]"
[7] ">QKO35589.1 recombinase family protein [Bacillus thuringiensis]"
[8] ">QKO35551.1 tyrosine-type recombinase/integrase [Bacillus thuringiensis]"
[9] ">QKO35280.1 recombinase family protein [Bacillus thuringiensis]"
[10] ">QKO34873.1 site-specific tyrosine recombinase XerD [Bacillus thuringiensis]"
[11] ">QKO34618.1 tyrosine recombinase XerC [Bacillus thuringiensis]"
[12] ">QKO34567.1 recombinase RecA [Bacillus thuringiensis]"
[13] ">QKO34482.1 recombinase family protein [Bacillus thuringiensis]"
[14] ">QKO32507.1 recombinase RecQ [Bacillus thuringiensis]"
[15] ">QKO32484.1 tyrosine-type recombinase/integrase [Bacillus thuringiensis]" #enzymes (aka "-ases")
head(grep("ase", proteome,value=TRUE))[1] ">QKO37046.1 helicase DnaB (plasmid) [Bacillus x1]"
[2] ">QKO37045.1 recombinase RecA (plasmid) [Bacillus thuringiensis]"
[3] ">QKO37043.1 IS3 family transposase (plasmid) [Bacillus thuringiensis]"
[4] ">QKO37040.1 serine acetyltransferase (plasmid) [Bacillus thuringiensis]"
[5] ">QKO37039.1 O-antigen ligase family protein (plasmid) [Bacillus thuringiensis]"
[6] ">QKO37026.1 HK97 family phage prohead protease (plasmid) [Bacillus thuringiensis]"head(grep("ase", proteome,value=TRUE,ignore.case=TRUE)) #lower- & uppercase[1] ">QKO37046.1 helicase DnaB (plasmid) [Bacillus x1]"
[2] ">QKO37045.1 recombinase RecA (plasmid) [Bacillus thuringiensis]"
[3] ">QKO37043.1 IS3 family transposase (plasmid) [Bacillus thuringiensis]"
[4] ">QKO37040.1 serine acetyltransferase (plasmid) [Bacillus thuringiensis]"
[5] ">QKO37039.1 O-antigen ligase family protein (plasmid) [Bacillus thuringiensis]"
[6] "SMSCDIDPTEIITRLTPLGTRIESKNEGATDASEARLTIESVNNGVPYIDHPSGIKEFGIQGKSITWDDV" #extract names
fastanames <- proteome[grep(proteome, pattern=">")] #extract the headers of all the sequences
names_ase <- fastanames[grep(fastanames, pattern="ase")]grep(pattern, x) finds elements of x that match a pattern.substr(x, start, stop) extracts characters by position.sub(pattern, replacement, x) replaces the first match in each element.These functions answer different questions. For example, if the protein ID always occupies positions 2 to 11 in the header, substr() is appropriate. If we want to remove the leading >, sub() is more appropriate.
sub() and substr(). [1] "QKO37046.1" "QKO37045.1" "QKO37043.1" "QKO37040.1" "QKO37039.1"
[6] "QKO37026.1" "QKO37024.1" "QKO37023.1" "QKO37022.1" "QKO37016.1"
[11] "QKO37013.1" "QKO37011.1" "QKO37005.1" "QKO36998.1" "QKO36995.1"
[16] "QKO36992.1" "QKO36990.1" "QKO36988.1" "QKO36987.1" "QKO36983.1"
[21] "QKO36981.1" "QKO36979.1" "QKO36974.1" "QKO36973.1" "QKO36972.1"
[26] "QKO36971.1" "QKO36970.1" "QKO36966.1" "QKO36958.1" "QKO36956.1"
[31] "QKO36954.1" "QKO36952.1" "QKO36940.1" "QKO36939.1" "QKO36938.1"
[36] "QKO36936.1" "QKO36935.1" "QKO36933.1" "QKO36932.1" "QKO36931.1"
[41] "QKO36928.1" "QKO36927.1" "QKO36926.1" "QKO36924.1" "QKO36923.1"
[46] "QKO36922.1" "QKO36921.1" "QKO36920.1" "QKO36918.1" "QKO36912.1"
[51] "QKO36909.1" "QKO36907.1" "QKO36905.1" "QKO36904.1" "QKO36903.1"
[56] "QKO36899.1" "QKO36897.1" "QKO36896.1" "QKO36894.1" "QKO36892.1"
[61] "QKO36891.1" "QKO36890.1" "QKO36889.1" "QKO36887.1" "QKO36885.1"
[66] "QKO36884.1" "QKO36883.1" "QKO36878.1" "QKO36875.1" "QKO36871.1"
[71] "QKO36866.1" "QKO36864.1" "QKO36855.1" "QKO36853.1" "QKO36850.1"
[76] "QKO36849.1" "QKO36848.1" "QKO36845.1" "QKO36844.1" "QKO36843.1"
[81] "QKO36842.1" "QKO36841.1" "QKO36833.1" "QKO36832.1" "QKO36829.1"
[86] "QKO36828.1" "QKO36822.1" "QKO36820.1" "QKO36814.1" "QKO36813.1"
[91] "QKO36812.1" "QKO36808.1" "QKO36807.1" "QKO36806.1" "QKO36805.1"
[96] "QKO36802.1" "QKO36796.1" "QKO36793.1" "QKO36791.1" "QKO36782.1"
--- Cropped output --- [1] "QKO37046.1 helicase DnaB (plasmid) [Bacillus x1]"
[2] "QKO37045.1 recombinase RecA (plasmid) [Bacillus thuringiensis]"
[3] "QKO37043.1 IS3 family transposase (plasmid) [Bacillus thuringiensis]"
[4] "QKO37040.1 serine acetyltransferase (plasmid) [Bacillus thuringiensis]"
[5] "QKO37039.1 O-antigen ligase family protein (plasmid) [Bacillus thuringiensis]"
[6] "QKO37026.1 HK97 family phage prohead protease (plasmid) [Bacillus thuringiensis]"
[7] "QKO37024.1 terminase large subunit (plasmid) [Bacillus thuringiensis]"
[8] "QKO37023.1 P27 family phage terminase small subunit (plasmid) [Bacillus thuringiensis]"
[9] "QKO37022.1 HNH endonuclease (plasmid) [Bacillus thuringiensis]"
[10] "QKO37016.1 nuclease (plasmid) [Bacillus thuringiensis]"
[11] "QKO37013.1 DNA primase (plasmid) [Bacillus thuringiensis]"
[12] "QKO37011.1 AAA family ATPase (plasmid) [Bacillus thuringiensis]"
[13] "QKO37005.1 sigma-70 family RNA polymerase sigma factor (plasmid) [Bacillus thuringiensis]"
[14] "QKO36998.1 recombinase family protein (plasmid) [Bacillus thuringiensis]"
[15] "QKO36995.1 IS3 family transposase (plasmid) [Bacillus thuringiensis]"
[16] "QKO36992.1 low molecular weight phosphotyrosine protein phosphatase (plasmid) [Bacillus thuringiensis]"
[17] "QKO36990.1 cadmium-translocating P-type ATPase (plasmid) [Bacillus thuringiensis]"
[18] "QKO36988.1 lysoplasmalogenase (plasmid) [Bacillus thuringiensis]"
[19] "QKO36987.1 signal peptidase I (plasmid) [Bacillus thuringiensis]"
[20] "QKO36983.1 IS4 family transposase (plasmid) [Bacillus thuringiensis]"
--- Cropped output ---regexpr()?# regexpr() returns the position where the match begins.
# The match length is stored as an attribute.
# Here we search for headers containing the word "DNA".
r <- regexpr(pattern = "(.*)DNA(.*)", text = fastanames[1:200])
r [1] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[26] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[51] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[76] -1 -1 1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[101] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[126] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[151] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[176] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
attr(,"match.length")
[1] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[26] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 58 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[51] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[76] -1 -1 95 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[101] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[126] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[151] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 68 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
[176] -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
attr(,"index.type")
[1] "chars"
attr(,"useBytes")
[1] TRUE# Which elements had a match?
dna <- which(r > 0, arr.ind = TRUE)
dna[1] 37 78 165# Extract the length of each match.
dna.length <- attr(r, "match.length")[dna]
# Extract matched headers with a loop.
nombres <- list()
for (i in seq_along(dna)) {
nombres[[i]] <- substr(fastanames[dna[i]], 1, dna.length[i])
}
head(nombres)[[1]]
[1] ">QKO37013.1 DNA primase (plasmid) [Bacillus thuringiensis]"
[[2]]
[1] ">QKO36972.1 DNA-3-methyladenine glycosylase 2 family protein (plasmid) [Bacillus thuringiensis]"
[[3]]
[1] ">QKO36885.1 DNA topoisomerase III (plasmid) [Bacillus thuringiensis]"You want to find all FASTA headers that contain the word recombinase. Which function is most directly useful?
Select the right answer
You want to remove the initial > from FASTA headers. Which function is most appropriate?
Select the right answer
Regular expressions are very convenient for a quick overview of FASTA files, but they do not understand sequences as biological objects. For more specific analyses, it is better to use sequence-aware packages. Two common options are seqinr and Biostrings.
In the following example, we are reading the same protein multifasta and we will obtain basic statistics, subset and save fasta sequences using SeqinR (=seqinr).
After readLines(), the FASTA file is just text. After read.fasta(), the same information is stored as a list of sequence objects. This changes how we access names, annotations and sequences.
#reading fasta and playing with it
if(!require(seqinr)) install.packages("seqinr", repos = "https://cran.rstudio.com/")
Cargando paquete requerido: seqinrWarning: package 'seqinr' was built under R version 4.6.1library(seqinr)
prots <- read.fasta("data/HER1410.fasta")
str(prots)List of 5807
$ QKO37049.1: 'SeqFastadna' chr [1:67] "m" "t" "l" "t" ...
..- attr(*, "name")= chr "QKO37049.1"
..- attr(*, "Annot")= chr ">QKO37049.1 hypothetical protein HBA75_30905 (plasmid) [Bacillus thuringiensis]"
$ QKO37048.1: 'SeqFastadna' chr [1:142] "m" "k" "v" "l" ...
..- attr(*, "name")= chr "QKO37048.1"
..- attr(*, "Annot")= chr ">QKO37048.1 hypothetical protein HBA75_30875 (plasmid) [Bacillus thuringiensis]"
$ QKO37047.1: 'SeqFastadna' chr [1:326] "m" "e" "k" "k" ...
..- attr(*, "name")= chr "QKO37047.1"
..- attr(*, "Annot")= chr ">QKO37047.1 cytosolic protein (plasmid) [Bacillus thuringiensis]"
$ QKO37046.1: 'SeqFastadna' chr [1:146] "m" "e" "k" "q" ...
..- attr(*, "name")= chr "QKO37046.1"
..- attr(*, "Annot")= chr ">QKO37046.1 helicase DnaB (plasmid) [Bacillus x1]"
$ QKO37045.1: 'SeqFastadna' chr [1:359] "m" "a" "a" "t" ...
..- attr(*, "name")= chr "QKO37045.1"
..- attr(*, "Annot")= chr ">QKO37045.1 recombinase RecA (plasmid) [Bacillus thuringiensis]"
$ QKO37044.1: 'SeqFastadna' chr [1:110] "m" "s" "y" "d" ...
..- attr(*, "name")= chr "QKO37044.1"
..- attr(*, "Annot")= chr ">QKO37044.1 hypothetical protein HBA75_31045 (plasmid) [Bacillus thuringiensis]"
$ QKO37043.1: 'SeqFastadna' chr [1:293] "m" "k" "a" "a" ...
..- attr(*, "name")= chr "QKO37043.1"
..- attr(*, "Annot")= chr ">QKO37043.1 IS3 family transposase (plasmid) [Bacillus thuringiensis]"
$ QKO37042.1: 'SeqFastadna' chr [1:102] "m" "g" "k" "i" ...
..- attr(*, "name")= chr "QKO37042.1"
..- attr(*, "Annot")= chr ">QKO37042.1 helix-turn-helix domain-containing protein (plasmid) [Bacillus thuringiensis]"
--- Cropped output ---getName(prots) [1] "QKO37049.1" "QKO37048.1" "QKO37047.1" "QKO37046.1" "QKO37045.1"
[6] "QKO37044.1" "QKO37043.1" "QKO37042.1" "QKO37041.1" "QKO37040.1"
[11] "QKO37039.1" "QKO37038.1" "QKO37037.1" "QKO37036.1" "QKO37035.1"
[16] "QKO37034.1" "QKO37033.1" "QKO37032.1" "QKO37031.1" "QKO37030.1"
[21] "QKO37029.1" "QKO37028.1" "QKO37027.1" "QKO37026.1" "QKO37025.1"
[26] "QKO37024.1" "QKO37023.1" "QKO37022.1" "QKO37021.1" "QKO37020.1"
[31] "QKO37019.1" "QKO37018.1" "QKO37017.1" "QKO37016.1" "QKO37015.1"
[36] "QKO37014.1" "QKO37013.1" "QKO37012.1" "QKO37011.1" "QKO37010.1"
[41] "QKO37009.1" "QKO37008.1" "QKO37007.1" "QKO37006.1" "QKO37005.1"
[46] "QKO37004.1" "QKO37003.1" "QKO37002.1" "QKO37001.1" "QKO37000.1"
[51] "QKO36999.1" "QKO36998.1" "QKO36997.1" "QKO36996.1" "QKO36995.1"
[56] "QKO36994.1" "QKO36993.1" "QKO36992.1" "QKO36991.1" "QKO36990.1"
[61] "QKO36989.1" "QKO36988.1" "QKO36987.1" "QKO36986.1" "QKO36985.1"
[66] "QKO36984.1" "QKO36983.1" "QKO36982.1" "QKO36981.1" "QKO36980.1"
[71] "QKO36979.1" "QKO36978.1" "QKO36977.1" "QKO36976.1" "QKO36975.1"
[76] "QKO36974.1" "QKO36973.1" "QKO36972.1" "QKO36971.1" "QKO36970.1"
[81] "QKO36969.1" "QKO36968.1" "QKO36967.1" "QKO36966.1" "QKO36965.1"
[86] "QKO36964.1" "QKO36963.1" "QKO36962.1" "QKO36961.1" "QKO36960.1"
[91] "QKO36959.1" "QKO36958.1" "QKO36957.1" "QKO36956.1" "QKO36955.1"
[96] "QKO36954.1" "QKO36953.1" "QKO36952.1" "QKO36951.1" "QKO36950.1"
[101] "QKO36949.1" "QKO36948.1" "QKO36947.1" "QKO36946.1" "QKO36945.1"
[106] "QKO36944.1" "QKO36943.1" "QKO36942.1" "QKO36941.1" "QKO36940.1"
[111] "QKO36939.1" "QKO36938.1" "QKO36937.1" "QKO36936.1" "QKO36935.1"
[116] "QKO36934.1" "QKO36933.1" "QKO36932.1" "QKO36931.1" "QKO36930.1"
[121] "QKO36929.1" "QKO36928.1" "QKO36927.1" "QKO36926.1" "QKO36925.1"
--- Cropped output ---prots[[1]] [1] "m" "t" "l" "t" "l" "h" "n" "g" "d" "l" "n" "k" "l" "a" "r" "d" "t" "s" "q"
[20] "d" "s" "i" "i" "l" "r" "v" "g" "e" "q" "e" "m" "v" "s" "l" "k" "s" "n" "g"
[39] "d" "i" "y" "v" "k" "g" "k" "l" "v" "e" "n" "d" "k" "e" "v" "v" "d" "g" "m"
[58] "r" "e" "l" "l" "m" "l" "s" "r" "k" "r"
attr(,"name")
[1] "QKO37049.1"
attr(,"Annot")
[1] ">QKO37049.1 hypothetical protein HBA75_30905 (plasmid) [Bacillus thuringiensis]"
attr(,"class")
[1] "SeqFastadna"seq <- getSequence(prots[[1]])
getName(prots[[1]])[1] "QKO37049.1"paste(seq, collapse= "")[1] "mtltlhngdlnklardtsqdsiilrvgeqemvslksngdiyvkgklvendkevvdgmrellmlsrkr"paste(prots[[1]], collapse= "")[1] "mtltlhngdlnklardtsqdsiilrvgeqemvslksngdiyvkgklvendkevvdgmrellmlsrkr"# Amino acid composition and molecular weight.
# Some seqinr functions expect uppercase characters and simple vectors.
aaa(toupper(seq)) [1] "Met" "Thr" "Leu" "Thr" "Leu" "His" "Asn" "Gly" "Asp" "Leu" "Asn" "Lys"
[13] "Leu" "Ala" "Arg" "Asp" "Thr" "Ser" "Gln" "Asp" "Ser" "Ile" "Ile" "Leu"
[25] "Arg" "Val" "Gly" "Glu" "Gln" "Glu" "Met" "Val" "Ser" "Leu" "Lys" "Ser"
[37] "Asn" "Gly" "Asp" "Ile" "Tyr" "Val" "Lys" "Gly" "Lys" "Leu" "Val" "Glu"
[49] "Asn" "Asp" "Lys" "Glu" "Val" "Val" "Asp" "Gly" "Met" "Arg" "Glu" "Leu"
[61] "Leu" "Met" "Leu" "Ser" "Arg" "Lys" "Arg"aaa(toupper(unlist(seq))) [1] "Met" "Thr" "Leu" "Thr" "Leu" "His" "Asn" "Gly" "Asp" "Leu" "Asn" "Lys"
[13] "Leu" "Ala" "Arg" "Asp" "Thr" "Ser" "Gln" "Asp" "Ser" "Ile" "Ile" "Leu"
[25] "Arg" "Val" "Gly" "Glu" "Gln" "Glu" "Met" "Val" "Ser" "Leu" "Lys" "Ser"
[37] "Asn" "Gly" "Asp" "Ile" "Tyr" "Val" "Lys" "Gly" "Lys" "Leu" "Val" "Glu"
[49] "Asn" "Asp" "Lys" "Glu" "Val" "Val" "Asp" "Gly" "Met" "Arg" "Glu" "Leu"
[61] "Leu" "Met" "Leu" "Ser" "Arg" "Lys" "Arg"aaa(toupper(as.vector(seq))) [1] "Met" "Thr" "Leu" "Thr" "Leu" "His" "Asn" "Gly" "Asp" "Leu" "Asn" "Lys"
[13] "Leu" "Ala" "Arg" "Asp" "Thr" "Ser" "Gln" "Asp" "Ser" "Ile" "Ile" "Leu"
[25] "Arg" "Val" "Gly" "Glu" "Gln" "Glu" "Met" "Val" "Ser" "Leu" "Lys" "Ser"
[37] "Asn" "Gly" "Asp" "Ile" "Tyr" "Val" "Lys" "Gly" "Lys" "Leu" "Val" "Glu"
[49] "Asn" "Asp" "Lys" "Glu" "Val" "Val" "Asp" "Gly" "Met" "Arg" "Glu" "Leu"
[61] "Leu" "Met" "Leu" "Ser" "Arg" "Lys" "Arg"pmw(toupper(unlist(seq))) [1] 7602.706(stats1 <- AAstat(toupper(seq), plot = T))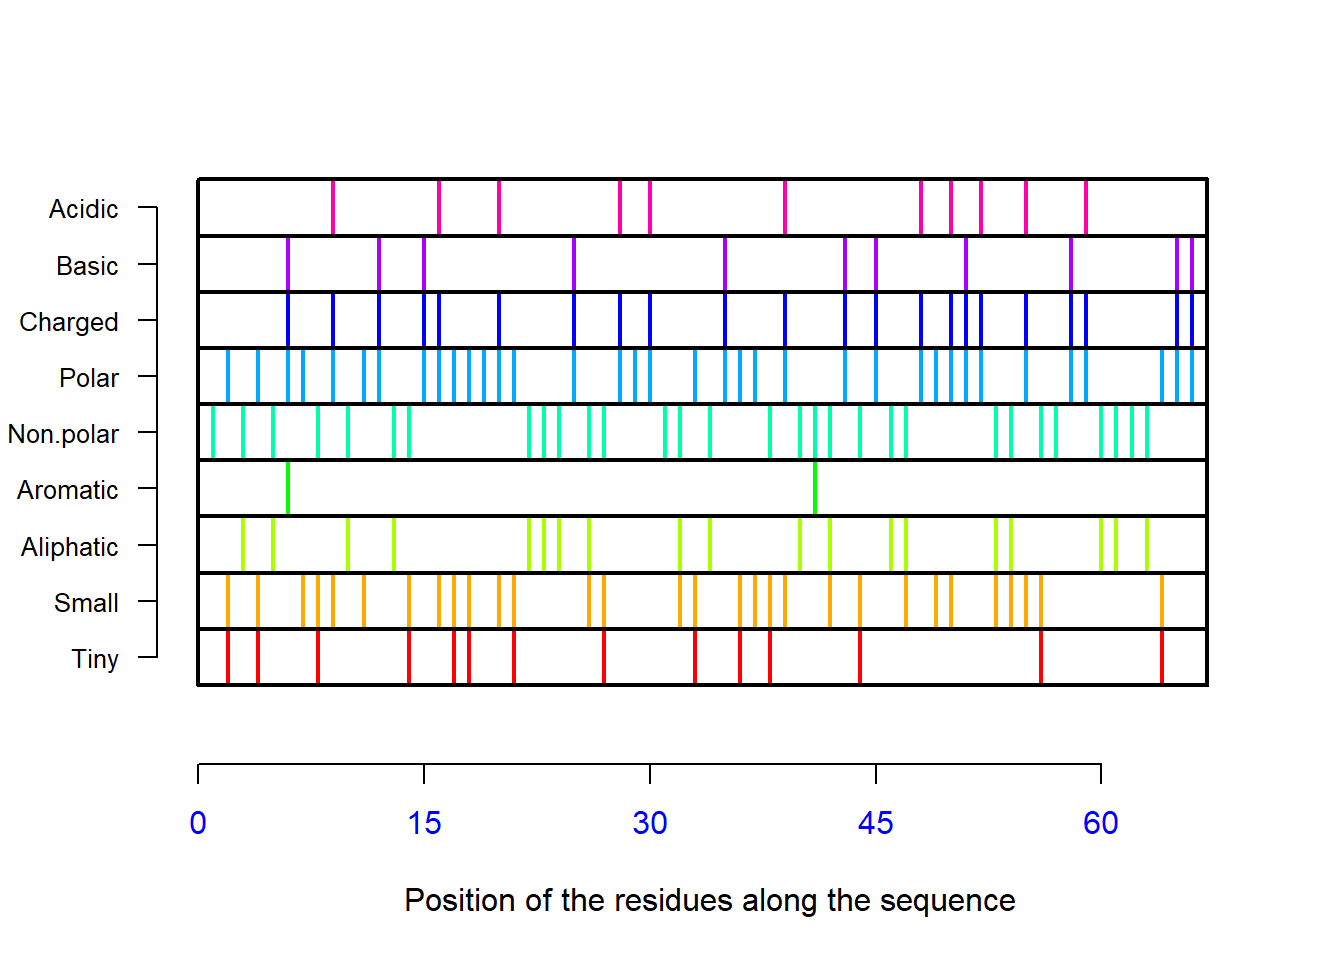
$Compo

 *  A  C  D  E  F  G  H  I  K  L  M  N  P  Q  R  S  T  V  W  Y
 0  1  0  6  5  0  5  1  3  6 10  4  4  0  2  5  5  3  6  0  1

$Prop
$Prop$Tiny
[1] 0.2089552

$Prop$Small
[1] 0.4477612

$Prop$Aliphatic
[1] 0.2835821

$Prop$Aromatic
[1] 0.02985075

$Prop$Non.polar
[1] 0.4477612

$Prop$Polar
[1] 0.5522388

$Prop$Charged
[1] 0.3432836

$Prop$Basic
[1] 0.1791045

$Prop$Acidic
[1] 0.1641791


$Pi
[1] 6.557213barplot(stats1$Compo, bty="7")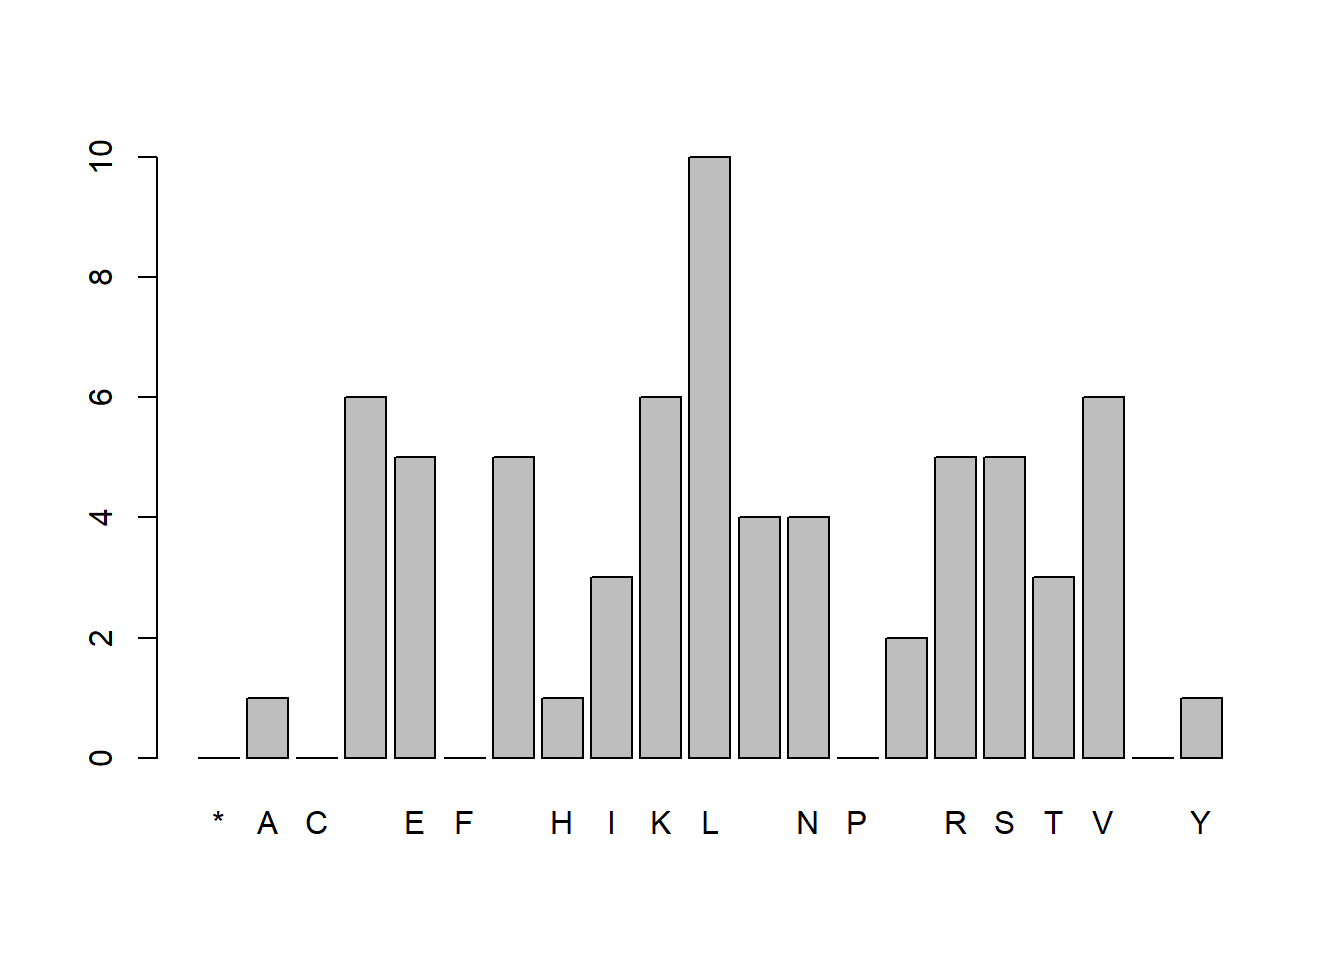
#cool color palette
library(RColorBrewer)
coul = colorRampPalette(brewer.pal(9, "Set1"))(20) #palette is expanded from 9 to 20 colors
barplot(stats1$Compo, col=coul, bty="7")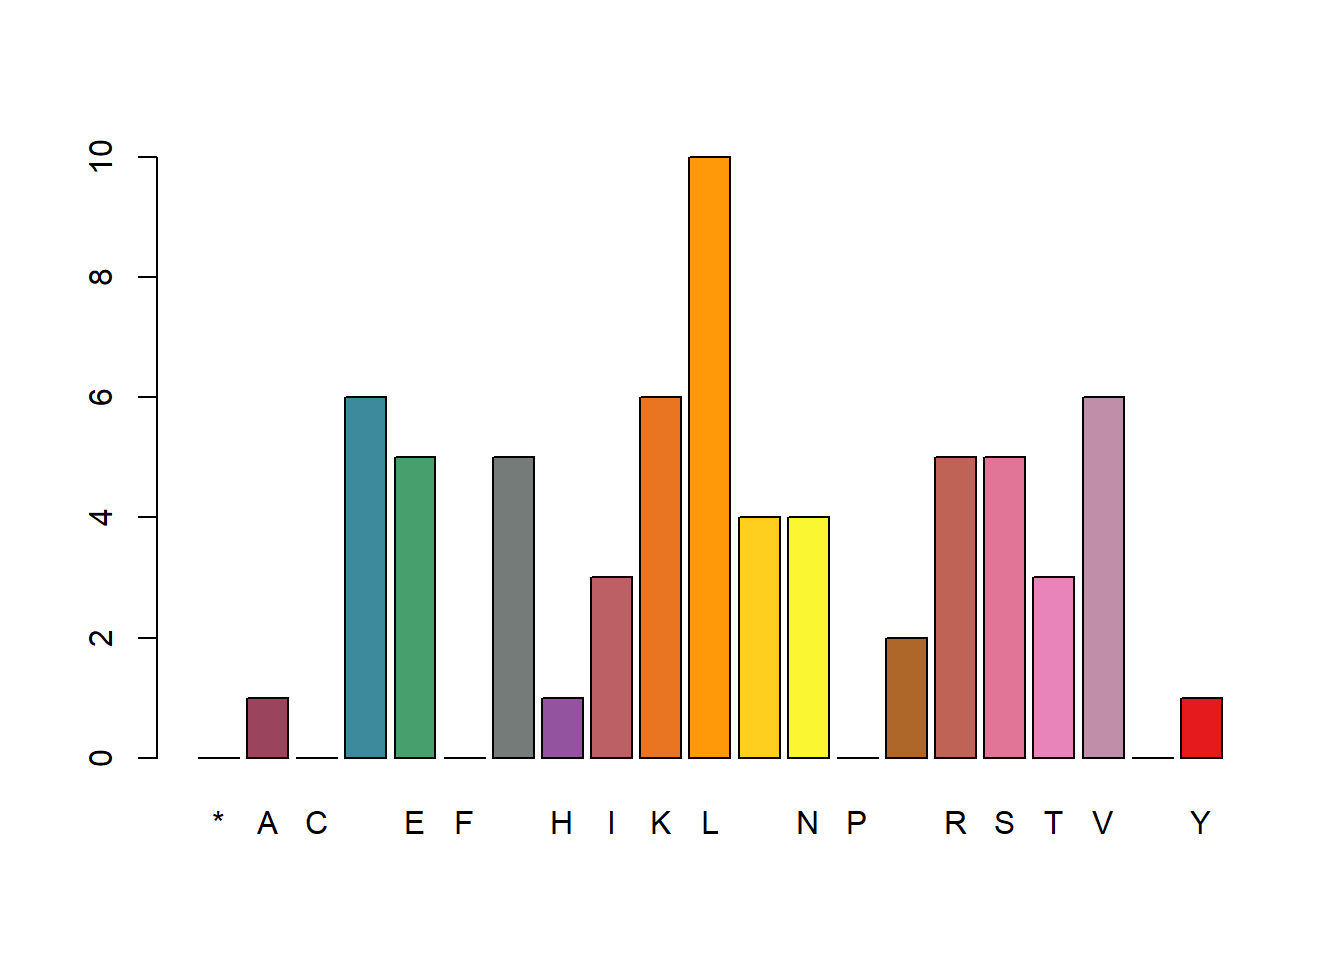
#dotplot
grep("recombinase",getAnnot(prots))
[1] 5 52 349 354 990 993 1461 1499 1770 2177 2432 2483 2568 4543 4566dotPlot(prots[[5]],prots[[2483]], wsize=3, nmatch=2)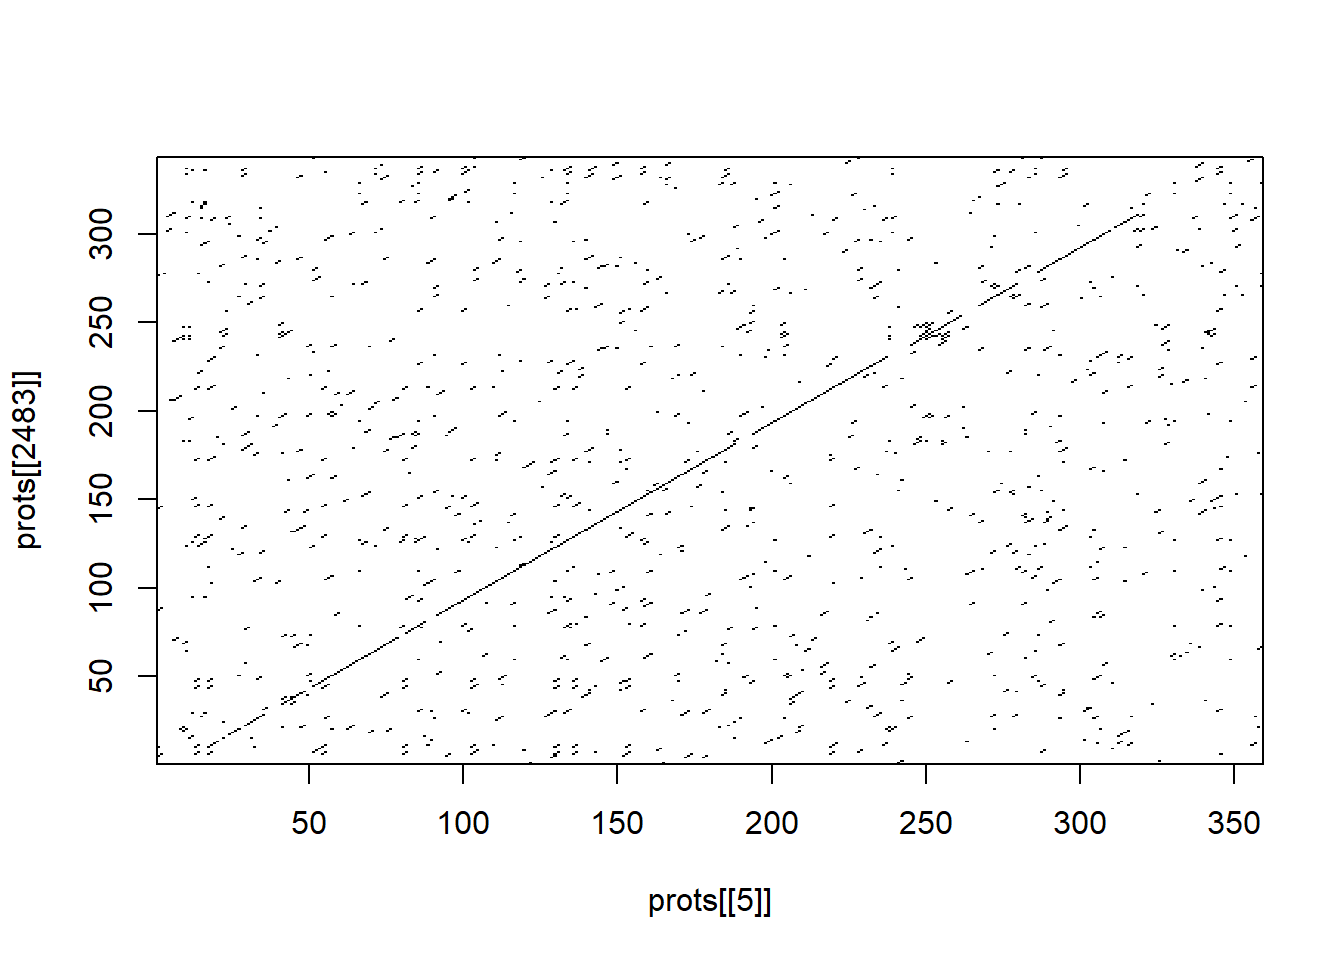
dotPlot(prots[[2177]],prots[[2432]], wsize=3, nmatch=2)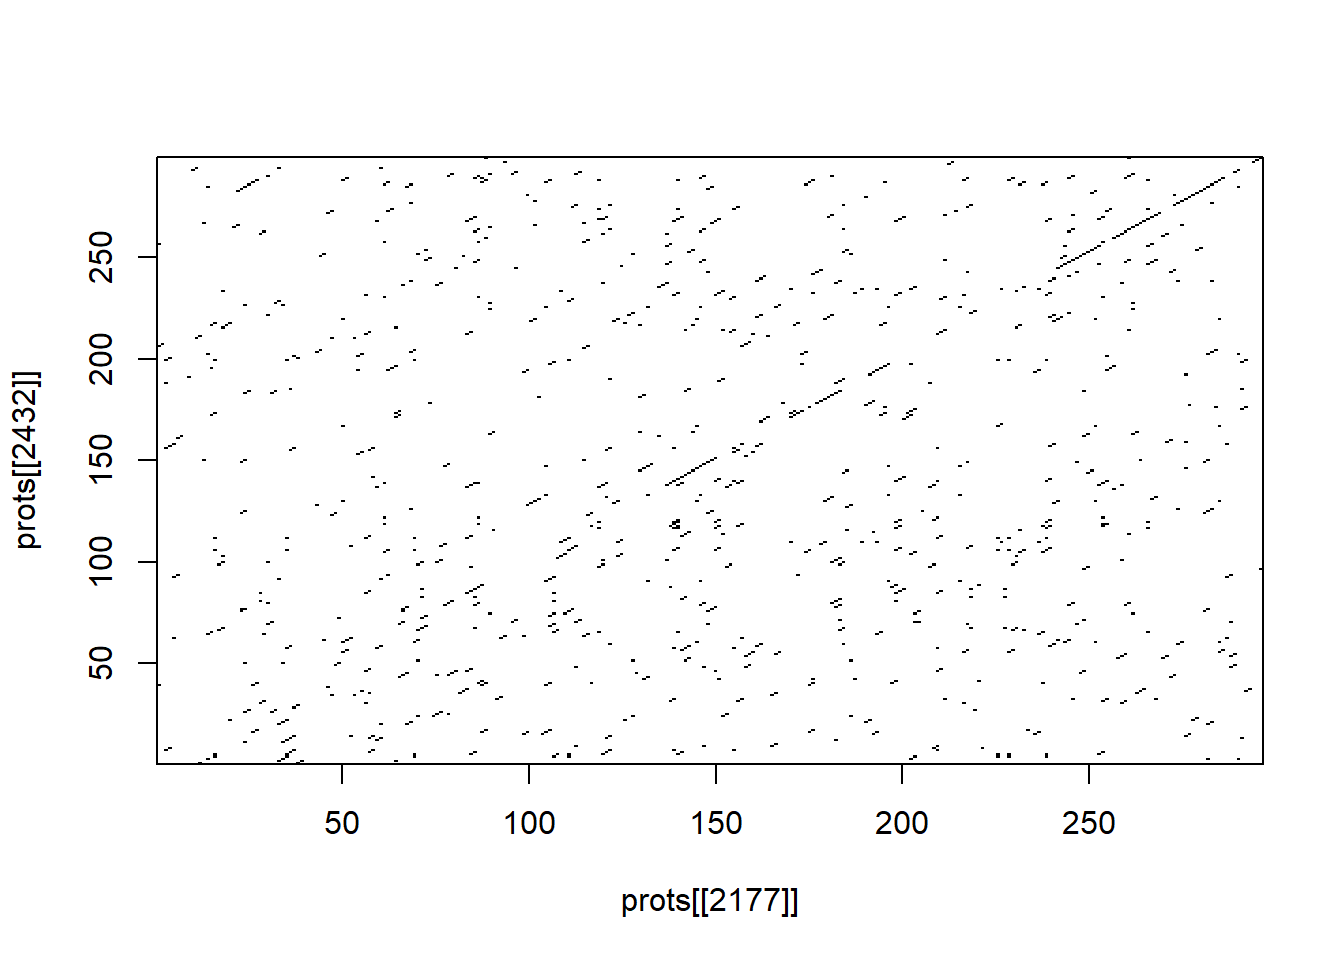
dotPlot(prots[[2177]],prots[[2432]], col=c("floralwhite","dodgerblue"),
        wsize=6, nmatch=3, xlab=getName(prots[[2177]]),ylab=getName(prots[[2432]]))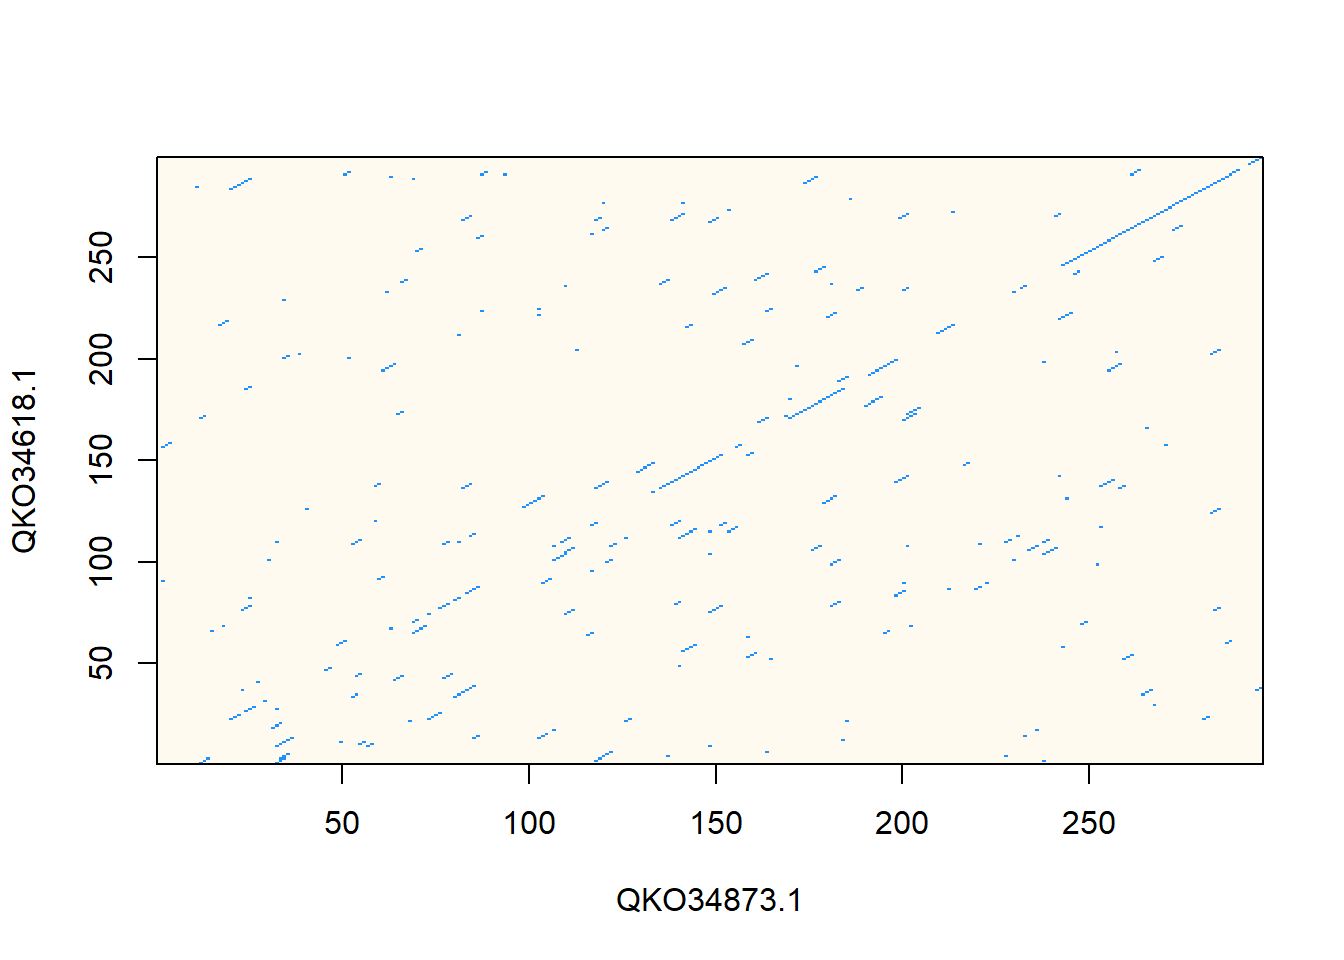
#extract the recombinases to a new file
recs <- prots[grep("recombinase",getAnnot(prots))]
#save to a file
write.fasta(recs, names=names(recs), file.out="data/recombinases.faa")
As you noticed in the code above, the function read.fasta() can read any (multi)fasta file containing a protein or nucleic acid sequence and create a list of lists. Thus, if you want to extract a sequence as a single element, you need to extract if from the list with unlist() or convert it to a vector with as.vector().
Once you read the fasta, you can extract the headline name with getName() or the sequence with getSequence(). Additionally, you can obtain and plot basic stats or compare sequences using dotPlot(). Moreover, if you extract a subset of sequences, you can use write.fasta() to save those sequences in a new fasta file.
Finally, as in the example below with HER1410 genome sequence (HER1410nt.fasta), you can also play with a nucleotide sequence and obtain some useful data, like the GC() content, the encoded proteins or the reverse complementary sequence with rev() and comp(), respectively.
Counting nucleotides, translating a sequence or calculating codon usage are technical operations. The biological interpretation depends on the molecule: genome, plasmid, coding sequence, partial sequence, strand, frame and annotation. Always write what the input sequence represents before interpreting the output.
#now the nt sequence
plasmid_nt <- read.fasta("data/HER1410nt.fasta")

count(unlist(plasmid_nt),3)
 aaa  aac  aag  aat  aca  acc  acg  act  aga  agc  agg  agt  ata  atc  atg  att
2150  705 1089 1420  715  253  321  484  900  437  525  601  992  589  955 1354
 caa  cac  cag  cat  cca  ccc  ccg  cct  cga  cgc  cgg  cgt  cta  ctc  ctg  ctt
 848  248  455  548  325   85  126  235  297  126  190  308  448  200  360  569
 gaa  gac  gag  gat  gca  gcc  gcg  gct  gga  ggc  ggg  ggt  gta  gtc  gtg  gtt
1273  273  418  829  467  128  212  384  641  224  292  516  620  230  484  755
 taa  tac  tag  tat  tca  tcc  tcg  tct  tga  tgc  tgg  tgt  tta  ttc  ttg  ttt
1093 547 501 1093 592 305 262 475 955 404 666 663 1174 615 889 1310 count(unlist(plasmid_nt),5)
aaaaa aaaac aaaag aaaat aaaca aaacc aaacg aaact aaaga aaagc aaagg aaagt aaata
  307   110   200   221   138    31    58    45   189    77   105    86   133
aaatc aaatg aaatt aacaa aacac aacag aacat aacca aaccc aaccg aacct aacga aacgc
  109   170   171   144    25    64    73    34    14    15    24    42    13
aacgg aacgt aacta aactc aactg aactt aagaa aagac aagag aagat aagca aagcc aagcg
   28    45    48    24    46    66   199    38    70   104    71    20    38
aagct aagga aaggc aaggg aaggt aagta aagtc aagtg aagtt aataa aatac aatag aatat
   61    97    33    40    70    96    13    55    84   112    80    52   116
aatca aatcc aatcg aatct aatga aatgc aatgg aatgt aatta aattc aattg aattt acaaa
   81    41    35    54   130    51    95    83   162    77   128   123   109
acaac acaag acaat acaca acacc acacg acact acaga acagc acagg acagt acata acatc
   54    63    67    27    18    20    24    52    34    39    44    37    27
acatg acatt accaa accac accag accat accca acccc acccg accct accga accgc accgg
   36    64    38    13    28    20    14     2     3    14    13    10     9
accgt accta acctc acctg acctt acgaa acgac acgag acgat acgca acgcc acgcg acgct
   16    19     5    20    29    45     8    14    35     9     6     2    23
acgga acggc acggg acggt acgta acgtc acgtg acgtt actaa actac actag actat actca
   32    13     8    21    35    10    27    33    39    24    20    44    30
actcc actcg actct actga actgc actgg actgt actta acttc acttg acttt agaaa agaac
    7    10    14    44    10    27    36    49    28    41    61   171    51
agaag agaat agaca agacc agacg agact agaga agagc agagg agagt agata agatc agatg
  109    84    35    16    19    13    54    15    39    39    85    19    75
agatt agcaa agcac agcag agcat agcca agccc agccg agcct agcga agcgc agcgg agcgt
   76    89    12    28    37    12     7    12    20    33    17    20    26
agcta agctc agctg agctt aggaa aggac aggag aggat aggca aggcc aggcg aggct aggga
   35    11    41    37    72    26    46    48    24     1    19    21    38
agggc agggg agggt aggta aggtc aggtg aggtt agtaa agtac agtag agtat agtca agtcc
   17    23    23    51    20    59    37    73    21    28    65    28    13
agtcg agtct agtga agtgc agtgg agtgt agtta agttc agttg agttt ataaa ataac ataag
    9    16    42    18    35    26    60    35    63    69   133    52    53
ataat ataca atacc atacg atact ataga atagc atagg atagt atata atatc atatg atatt
   84    79    29    40    46    46    25    20    36    79    74    77   119
atcaa atcac atcag atcat atcca atccc atccg atcct atcga atcgc atcgg atcgt atcta
   94    32    37    63    50     8    16    39    40    11    17    32    59
atctc atctg atctt atgaa atgac atgag atgat atgca atgcc atgcg atgct atgga atggc
   18    25    48   184    36    36    94    65    17    20    48    80    35
atggg atggt atgta atgtc atgtg atgtt attaa attac attag attat attca attcc attcg
   47    69    73    29    34    88   114    92    85   100    83    36    45
attct attga attgc attgg attgt attta atttc atttg atttt caaaa caaac caaag caaat
   50   111    43    91    76   153    60    89   126   133    45    57    99
caaca caacc caacg caact caaga caagc caagg caagt caata caatc caatg caatt cacaa
   44    11    18    42    59    32    32    47    63    25    38   103    39
cacac cacag cacat cacca caccc caccg cacct cacga cacgc cacgg cacgt cacta cactc
   12    26    22    14     3    10    17    14     7    11    11    13     8
cactg cactt cagaa cagac cagag cagat cagca cagcc cagcg cagct cagga caggc caggg
   12    29    52    15    28    46    39    10    26    27    29    13    19
caggt cagta cagtc cagtg cagtt cataa catac catag catat catca catcc catcg catct
   35    34    16    14    52    37    26     7    63    37    15    13    29
catga catgc catgg catgt catta cattc cattg cattt ccaaa ccaac ccaag ccaat ccaca
   38    15    21    18    68    35    46    80    46    14    28    35    27
ccacc ccacg ccact ccaga ccagc ccagg ccagt ccata ccatc ccatg ccatt cccaa cccac
    5     6     4    24    17    16    21    18    16     9    39    14     3
cccag cccat cccca ccccc ccccg cccct cccga cccgc cccgg cccgt cccta ccctc ccctg
    7    11     6     4     1     5     3     1     0     2    13     2     5
ccctt ccgaa ccgac ccgag ccgat ccgca ccgcc ccgcg ccgct ccgga ccggc ccggg ccggt
    8    19     6     2     8     7     6     3     6     9     3     2     7
ccgta ccgtc ccgtg ccgtt cctaa cctac cctag cctat cctca cctcc cctcg cctct cctga
   11     7    10    20    23     6     6    28     7     5     3     6    21
cctgc cctgg cctgt cctta ccttc ccttg ccttt cgaaa cgaac cgaag cgaat cgaca cgacc
    6    18    11    27    16    13    39    50    12    27    32    10     6
cgacg cgact cgaga cgagc cgagg cgagt cgata cgatc cgatg cgatt cgcaa cgcac cgcag
    3    14    10     7     5     9    31     9    38    34    18     7    15
cgcat cgcca cgccc cgccg cgcct cgcga cgcgc cgcgg cgcgt cgcta cgctc cgctg cgctt
   13     9     0     3     4     3     1     4     3    12     5    12    16
cggaa cggac cggag cggat cggca cggcc cggcg cggct cggga cgggc cgggg cgggt cggta
   36     9    18    23     9     5     3    11     9     2     3     7    23
cggtc cggtg cggtt cgtaa cgtac cgtag cgtat cgtca cgtcc cgtcg cgtct cgtga cgtgc
    2    13    17    32    16     5    35    14     5     6    13    24    12
cgtgg cgtgt cgtta cgttc cgttg cgttt ctaaa ctaac ctaag ctaat ctaca ctacc ctacg
   17    20    31    21    19    38    74    23    19    42    24     4    13
ctact ctaga ctagc ctagg ctagt ctata ctatc ctatg ctatt ctcaa ctcac ctcag ctcat
   26    24     5    11    20    42    30    33    58    29     9    12    24
ctcca ctccc ctccg ctcct ctcga ctcgc ctcgg ctcgt ctcta ctctc ctctg ctctt ctgaa
   13     4     6    11     9     5     4    14    18    10     5    27    76
ctgac ctgag ctgat ctgca ctgcc ctgcg ctgct ctgga ctggc ctggg ctggt ctgta ctgtc
    9    13    41    20     3     2    17    24    12    13    31    27    11
ctgtg ctgtt cttaa cttac cttag cttat cttca cttcc cttcg cttct cttga cttgc cttgg
   22    39    51    22    29    54    30    16     5    35    45    21    32
cttgt cttta ctttc ctttg ctttt gaaaa gaaac gaaag gaaat gaaca gaacc gaacg gaact
   30    70    27    33    69   205    71    92   140    68    23    28    38
gaaga gaagc gaagg gaagt gaata gaatc gaatg gaatt gacaa gacac gacag gacat gacca
  124    60    60    67    72    43    76   106    34    13    22    29    16
gaccc gaccg gacct gacga gacgc gacgg gacgt gacta gactc gactg gactt gagaa gagac
    5    12    14    22     6    11    16    24    11    14    24    74    15
gagag gagat gagca gagcc gagcg gagct gagga gaggc gaggg gaggt gagta gagtc gagtg
   23    39    21    14    12    13    37     8    21    30    23    20    25
gagtt gataa gatac gatag gatat gatca gatcc gatcg gatct gatga gatgc gatgg gatgt
   43    78    38    37    86    22    18    14    16   103    44    50    62
gatta gattc gattg gattt gcaaa gcaac gcaag gcaat gcaca gcacc gcacg gcact gcaga
   62    43    57    99    82    19    41    62    14     6    10    14    32
gcagc gcagg gcagt gcata gcatc gcatg gcatt gccaa gccac gccag gccat gccca gcccc
   31    23    15    27    16    21    54    18     3    14    15     5     3
gcccg gccct gccga gccgc gccgg gccgt gccta gcctc gcctg gcctt gcgaa gcgac gcgag
    1     1     6     3     5    11    10     4    11    18    24    10     7
gcgat gcgca gcgcc gcgcg gcgct gcgga gcggc gcggg gcggt gcgta gcgtc gcgtg gcgtt
   27    22     1     3     4    26     5     4    16    15     8    16    24
gctaa gctac gctag gctat gctca gctcc gctcg gctct gctga gctgc gctgg gctgt gctta
   38    15    17    38    15    11    11    15    51    22    18    24    31
gcttc gcttg gcttt ggaaa ggaac ggaag ggaat ggaca ggacc ggacg ggact ggaga ggagc
   15    26    36   105    44    47    69    25    10    18    19    53    19
ggagg ggagt ggata ggatc ggatg ggatt ggcaa ggcac ggcag ggcat ggcca ggccc ggccg
   28    28    49    13    46    68    32     6    20    26    14     2     3
ggcct ggcga ggcgc ggcgg ggcgt ggcta ggctc ggctg ggctt gggaa gggac gggag gggat
    6    12     8    12    18    17    11    17    20    50    12    16    35
gggca gggcc gggcg gggct gggga ggggc ggggg ggggt gggta gggtc gggtg gggtt ggtaa
   19     5    10    14    17    15    13    13    20     4    21    28    66
ggtac ggtag ggtat ggtca ggtcc ggtcg ggtct ggtga ggtgc ggtgg ggtgt ggtta ggttc
   28    18    40    18     6    15    14    69    35    29    34    32    28
ggttg ggttt gtaaa gtaac gtaag gtaat gtaca gtacc gtacg gtact gtaga gtagc gtagg
   28    56    99    37    29    73    39    12    14    21    36    15    18
gtagt gtata gtatc gtatg gtatt gtcaa gtcac gtcag gtcat gtcca gtccc gtccg gtcct
   19    38    50    50    70    29     9    15    27    23     2     6    11
gtcga gtcgc gtcgg gtcgt gtcta gtctc gtctg gtctt gtgaa gtgac gtgag gtgat gtgca
   16     5     9    12    16    10    14    26    73    15    26    58    30
gtgcc gtgcg gtgct gtgga gtggc gtggg gtggt gtgta gtgtc gtgtg gtgtt gttaa gttac
    5     8    28    72    13    16    31    30    16    15    48    64    29
gttag gttat gttca gttcc gttcg gttct gttga gttgc gttgg gttgt gttta gtttc gtttg
   28    72    42    29    19    42    50    34    39    55    64    44    51
gtttt taaaa taaac taaag taaat taaca taacc taacg taact taaga taagc taagg taagt
   93   193    46   108   123    56    22    24    59    39    21    43    48
taata taatc taatg taatt tacaa tacac tacag tacat tacca taccc taccg tacct tacga
   92    34    75   110    76    39    57    40    35    11    11    18    24
tacgc tacgg tacgt tacta tactc tactg tactt tagaa tagac tagag tagat tagca tagcc
   14    24    33    42    18    45    60    90    15    26    66    35     7
tagcg tagct tagga taggc taggg taggt tagta tagtc tagtg tagtt tataa tatac tatag
   20    23    29    11    21    32    34    17    27    48    95    50    31
tatat tatca tatcc tatcg tatct tatga tatgc tatgg tatgt tatta tattc tattg tattt
   84    86    39    38    51    79    40    65    61    99    59    90   126
tcaaa tcaac tcaag tcaat tcaca tcacc tcacg tcact tcaga tcagc tcagg tcagt tcata
   97    28    38    65    31    15     7    20    33    20    18    36    51
tcatc tcatg tcatt tccaa tccac tccag tccat tccca tcccc tcccg tccct tccga tccgc
   35    26    72    53    23    29    36    10     7     1     8    13     8
tccgg tccgt tccta tcctc tcctg tcctt tcgaa tcgac tcgag tcgat tcgca tcgcc tcgcg
    7    19    21    10    20    40    33     9     8    42    15     3     3
tcgct tcgga tcggc tcggg tcggt tcgta tcgtc tcgtg tcgtt tctaa tctac tctag tctat
   13    19     7     7    11    27    13    20    32    58    22    17    53
tctca tctcc tctcg tctct tctga tctgc tctgg tctgt tctta tcttc tcttg tcttt tgaaa
   22    11     8    25    23     4    17    28    49    27    48    63   182
tgaac tgaag tgaat tgaca tgacc tgacg tgact tgaga tgagc tgagg tgagt tgata tgatc
   50   128   112    28    15    15    27    34    19    24    35    74    29
tgatg tgatt tgcaa tgcac tgcag tgcat tgcca tgccc tgccg tgcct tgcga tgcgc tgcgg
  100    83    65    19    38    42    15     1     7    13    20     4    15
tgcgt tgcta tgctc tgctg tgctt tggaa tggac tggag tggat tggca tggcc tggcg tggct
   16    44    25    45    35   107    25    48    70    32    14    18    19
tggga tgggc tgggg tgggt tggta tggtc tggtg tggtt tgtaa tgtac tgtag tgtat tgtca
   49    14    19    30    58    27    74    62    67    21    37    68    20
tgtcc tgtcg tgtct tgtga tgtgc tgtgg tgtgt tgtta tgttc tgttg tgttt ttaaa ttaac
   18    12    23    37     6    51    29    70    48    68    88   164    49
ttaag ttaat ttaca ttacc ttacg ttact ttaga ttagc ttagg ttagt ttata ttatc ttatg
   50   112    70    30    28    72    91    40    44    51   101    60    85
ttatt ttcaa ttcac ttcag ttcat ttcca ttccc ttccg ttcct ttcga ttcgc ttcgg ttcgt
  127    76    23    43    70    55    12    19    30    27    13    14    34
ttcta ttctc ttctg ttctt ttgaa ttgac ttgag ttgat ttgca ttgcc ttgcg ttgct ttgga
   57    28    28    86   139    25    37    93    49    11    25    56    74
ttggc ttggg ttggt ttgta ttgtc ttgtg ttgtt tttaa tttac tttag tttat tttca tttcc
   23    36    90    63    17    52    99   146    57    84   147    57    35
tttcg tttct tttga tttgc tttgg tttgt tttta ttttc ttttg ttttt
19 72 88 43 61 70 147 52 89 143 uco(plasmid_nt[[1]],frame=0)
aaa aac aag aat aca acc acg act aga agc agg agt ata atc atg att caa cac cag cat
722 239 389 463 238  84 114 144 286 145 148 192 318 190 328 464 291  88 156 187
cca ccc ccg cct cga cgc cgg cgt cta ctc ctg ctt gaa gac gag gat gca gcc gcg gct
125  22  49  94  94  40  62  90 148  73 158 197 374  82 145 267 125  30  75 130
gga ggc ggg ggt gta gtc gtg gtt taa tac tag tat tca tcc tcg tct tga tgc tgg tgt
241  78  96 184 220  78 181 249 408 194 181 327 178  88  88 155 341 118 185 223
tta ttc ttg ttt
404 206 313 414 uco(plasmid_nt[[1]],frame=2)
aaa aac aag aat aca acc acg act aga agc agg agt ata atc atg att caa cac cag cat
720 234 340 462 233  89  93 175 283 131 182 225 376 182 328 460 300  82 152 177
cca ccc ccg cct cga cgc cgg cgt cta ctc ctg ctt gaa gac gag gat gca gcc gcg gct
 96  37  39  85  97  34  61 117 139  54  96 189 461  97 135 270 183  53  74 140
gga ggc ggg ggt gta gtc gtg gtt taa tac tag tat tca tcc tcg tct tga tgc tgg tgt
215  66 109 193 211  73 144 244 332 167 144 391 210 111  80 177 273 129 247 192
tta ttc ttg ttt
384 200 299 444 translate(plasmid_nt[[1]]) [1] "V" "W" "S" "I" "K" "H" "N" "L" "T" "T" "S" "N" "E" "Y" "S" "*" "A" "A"
[19] "I" "I" "L" "F" "*" "N" "L" "*" "P" "L" "L" "L" "V" "Q" "L" "D" "S" "Y"
[37] "L" "H" "E" "Q" "V" "L" "*" "L" "R" "L" "*" "W" "K" "I" "Q" "L" "H" "L"
[55] "L" "L" "L" "S" "*" "I" "R" "C" "L" "N" "C" "T" "I" "H" "L" "S" "T" "D"
[73] "L" "K" "V" "L" "L" "F" "Q" "V" "K" "R" "L" "Y" "Q" "L" "Y" "*" "P" "V"
[91] "V" "F" "E" "L" "C" "S" "L" "L" "G" "L" "G" "L" "T" "Y" "P" "F" "Y" "I"
[109] "R" "S" "*" "E" "Y" "L" "L" "L" "*" "T" "D" "I" "L" "N" "V" "L" "S" "Y"
[127] "L" "G" "F" "C" "Y" "I" "V" "L" "V" "N" "Y" "L" "T" "L" "L" "V" "S" "L"
[145] "Q" "Y" "H" "Q" "D" "Q" "R" "W" "R" "L" "P" "R" "G" "L" "E" "I" "L" "F"
[163] "Q" "L" "H" "P" "L" "E" "L" "E" "A" "Y" "R" "M" "F" "L" "Y" "D" "V" "L"
[181] "S" "Y" "T" "Y" "S" "S" "L" "Q" "F" "Y" "Y" "G" "F" "L" "L" "V" "Y" "F"
[199] "P" "K" "N" "A" "F" "R" "I" "W" "R" "T" "L" "K" "H" "*" "R" "I" "R" "K"
[217] "N" "Y" "A" "I" "*" "L" "C" "L" "S" "F" "Y" "Y" "L" "V" "L" "V" "V" "Q"
[235] "Y" "T" "K" "Y" "L" "Y" "Q" "*" "K" "F" "R" "N" "P" "F" "E" "Q" "C" "L"
[253] "L" "E" "C" "R" "L" "P" "S" "G" "F" "F" "Q" "C" "K" "S" "D" "Y" "L" "*"
[271] "Y" "S" "V" "Q" "H" "H" "N" "*" "I" "F" "S" "L" "S" "*" "S" "*" "R" "H"
[289] "D" "C" "L" "K" "I" "L" "R" "C" "L" "L" "Y" "L" "L" "F" "*" "T" "S" "R"
[307] "I" "C" "I" "L" "Q" "F" "Q" "P" "Q" "*" "D" "*" "Y" "I" "S" "F" "L" "C"
[325] "L" "G" "H" "I" "P" "W" "V" "I" "*" "L" "R" "F" "S" "D" "L" "I" "Q" "P"
[343] "F" "C" "A" "W" "N" "L" "S" "H" "V" "L" "L" "L" "S" "L" "V" "P" "I" "A"
[361] "Q" "V" "S" "Q" "L" "R" "*" "*" "T" "F" "F" "R" "*" "R" "L" "L" "Y" "Q"
[379] "I" "S" "L" "C" "Y" "F" "*" "I" "*" "H" "Y" "I" "H" "P" "L" "F" "L" "E"
[397] "W" "N" "V" "S" "L" "I" "L" "N" "E" "*" "I" "D" "L" "I" "Y" "K" "Q" "E"
[415] "*" "Y" "Q" "I" "V" "F" "S" "S" "Y" "L" "L" "S" "F" "F" "E" "K" "Q" "V"
[433] "V" "L" "Y" "F" "S" "H" "Y" "I" "L" "H" "H" "S" "N" "H" "L" "Q" "L" "P"
--- Cropped output ---GC(plasmid_nt[[1]])[1] 0.3437746plasmid_nt[[1]][1:100] [1] "g" "t" "t" "t" "g" "g" "t" "c" "a" "a" "t" "t" "a" "a" "a" "c" "a" "c"
[19] "a" "a" "c" "c" "t" "a" "a" "c" "t" "a" "c" "a" "t" "c" "a" "a" "a" "t"
[37] "g" "a" "a" "t" "a" "c" "a" "g" "t" "t" "a" "g" "g" "c" "t" "g" "c" "g"
[55] "a" "t" "t" "a" "t" "t" "t" "t" "a" "t" "t" "t" "t" "g" "a" "a" "a" "t"
[73] "c" "t" "g" "t" "a" "a" "c" "c" "t" "t" "t" "a" "t" "t" "a" "c" "t" "g"
[91] "g" "t" "g" "c" "a" "a" "t" "t" "g" "g"comp(plasmid_nt[[1]][1:100]) [1] "c" "a" "a" "a" "c" "c" "a" "g" "t" "t" "a" "a" "t" "t" "t" "g" "t" "g"
[19] "t" "t" "g" "g" "a" "t" "t" "g" "a" "t" "g" "t" "a" "g" "t" "t" "t" "a"
[37] "c" "t" "t" "a" "t" "g" "t" "c" "a" "a" "t" "c" "c" "g" "a" "c" "g" "c"
[55] "t" "a" "a" "t" "a" "a" "a" "a" "t" "a" "a" "a" "a" "c" "t" "t" "t" "a"
[73] "g" "a" "c" "a" "t" "t" "g" "g" "a" "a" "a" "t" "a" "a" "t" "g" "a" "c"
[91] "c" "a" "c" "g" "t" "t" "a" "a" "c" "c"rev(comp(plasmid_nt[[1]][1:100])) [1] "c" "c" "a" "a" "t" "t" "g" "c" "a" "c" "c" "a" "g" "t" "a" "a" "t" "a"
[19] "a" "a" "g" "g" "t" "t" "a" "c" "a" "g" "a" "t" "t" "t" "c" "a" "a" "a"
[37] "a" "t" "a" "a" "a" "a" "t" "a" "a" "t" "c" "g" "c" "a" "g" "c" "c" "t"
[55] "a" "a" "c" "t" "g" "t" "a" "t" "t" "c" "a" "t" "t" "t" "g" "a" "t" "g"
[73] "t" "a" "g" "t" "t" "a" "g" "g" "t" "t" "g" "t" "g" "t" "t" "t" "a" "a"
[91] "t" "t" "g" "a" "c" "c" "a" "a" "a" "c"You can query to NCBI, Uniprot and other databases directly using seqinr. The seqinr package was written by the group that created the ACNUC database in Lyon, France (http://pbil.univ-lyon1.fr/databases/acnuc/acnuc.html). The ACNUC database is a database that contains most of the data from the NCBI Sequence Database, as well as data from other sequence databases such as UniProt and Ensembl. the ACNUC database is organised into various different ACNUC (sub)-databases, which contain different parts of the NCBI database, and when you want to search the NCBI database via R, you will need to specify which ACNUC sub-database the NCBI data that you want to query is stored in.
To obtain a full list of the ACNUC sub-databases that you can access using seqinr, you can use the choosebank() function from seqinr. Then, you just need to select the database and query your sequence. However, as you can see in the example below it does not work currently. I mentioned this here because I used this previously and found it very useful. In case you want to try it again in the future you can check the examples in the Reference 4 below.
choosebank() [1] "genbank" "embl" "emblwgs" "genbankseqinr"
[5] "swissprot" "ensembl" "hogenom7dna" "hogenom7"
[9] "hogenom" "hovergendna" "hovergen" "phever2"
[13] "phever2dna" "refseq" "refseq16s" "ensprotists"
[17] "ensfungi" "ensmetazoa" "ensplants" "ensemblbacteria"
[21] "mito" "emglib" "refseqViruses" "ribodb" #select genbank
choosebank("swissprot")
pol <- query("pol","AC=P0DPS1",verbose=TRUE,invisible=FALSE)I'm checking the arguments...
... and everything is OK up to now.
I'm checking the status of the socket connection...
... and everything is OK up to now.
I'm sending query to server...
... answer from server is: code=0&lrank=2&count=1&type=SQ&locus=T
I'm trying to analyse answer from server...
... and everything is OK up to now.
... and the rank of the resulting list is: 2 .
... and there are 1 elements in the list.
... and the elements in the list are of type SQ .
... and there are only parent sequences in the list.
I'm trying to get the infos about the elements of the list...
... and I have received 1 lines as expected.polseq <- getSequence(pol$req[[1]])
closebank()Like seqinr, other R packages allow accessing to NCBI and other databases, including APE or genbankr. The latter takes advantage of the packages rentrez.
rentrez is an R package that helps users query the NCBI’s databases to download diverse type of data and metadata, including sequences or research papers.
if(!require(rentrez)){
   install.packages("rentrez", repos = "https://cran.rstudio.com/")
}
Cargando paquete requerido: rentrezWarning: package 'rentrez' was built under R version 4.6.1library(rentrez)
(pols <- entrez_search(db = "pubmed", term = "DNA polymerase") )Entrez search result with 380909 hits (object contains 20 IDs and no web_history object)
Search term (as translated): "dna directed dna polymerase"[Supplementary Concep ... str(pols)List of 5
$ ids : chr [1:20] "42610908" "42610786" "42610739" "42610298" ...
$ count : int 380909
$ retmax : int 20
$ QueryTranslation: chr "\"dna directed dna polymerase\"[Supplementary Concept] OR \"dna directed dna polymerase\"[All Fields] OR \"dna "| __truncated__
$ file :Classes 'XMLInternalDocument', 'XMLAbstractDocument' <pointer: 0x0000010953afe1b0>
- attr(*, "class")= chr [1:2] "esearch" "list"(Gon <- entrez_search(db = "pubmed", term = "Gonzalez", retmax=100))Entrez search result with 78138 hits (object contains 100 IDs and no web_history object)
Search term (as translated): "Gonzalez"[All Fields] Gon$ids #now kept 100 [1] "42611012" "42610719" "42610673" "42610369" "42610066" "42609624"
[7] "42609470" "42609098" "42608522" "42608361" "42608214" "42608132"
[13] "42608017" "42607945" "42607542" "42607417" "42607149" "42606497"
[19] "42606425" "42606293" "42606280" "42606018" "42605531" "42605359"
[25] "42605305" "42604533" "42604080" "42604008" "42603991" "42602869"
[31] "42602722" "42602528" "42602480" "42602350" "42601166" "42600688"
[37] "42600177" "42599835" "42599702" "42599438" "42598990" "42598584"
[43] "42596760" "42596012" "42595947" "42595846" "42595753" "42595729"
[49] "42595300" "42595014" "42594771" "42594196" "42593953" "42593629"
[55] "42593620" "42593591" "42592627" "42592493" "42592491" "42592323"
[61] "42592249" "42591436" "42591398" "42591297" "42590198" "42590175"
[67] "42590032" "42589719" "42589390" "42589360" "42589312" "42589218"
[73] "42588921" "42588601" "42587923" "42587603" "42587422" "42587356"
[79] "42586785" "42586240" "42585376" "42585333" "42585015" "42584808"
[85] "42584162" "42583913" "42583500" "42582759" "42581758" "42581252"
[91] "42580964" "42580948" "42580401" "42580343" "42580051" "42579884"
[97] "42579774" "42579334" "42578920" "42578817"#we can also fetch data
her1410 <- entrez_search(db = "nuccore", term = "HER1410")
her1410$ids[1] "1853362518" "1853362517" "1853362516" "1853362515" "1852678087"
[6] "1852677931" "1852677628" "1852672161" "183211906" her1410_1 <- entrez_fetch(db="nuccore", id=her1410$ids[1], rettype="fasta")
head(her1410_1)[1] ">NZ_CP050186.1 Bacillus thuringiensis strain HER1410 plasmid pLUSID3, complete sequence\nGTTTGGTCAATTAAACACAACCTAACTACATCAAATGAATACAGTTAGGCTGCGATTATTTTATTTTGAA\nATCTGTAACCTTTATTACTGGTGCAATTGGATTCTTACCTACACGAGCAGGTTTTGTGACTTCGACTGTA\nATGGAAGATACAATTGCATTTACTGCTGCTTTCTTAGATTCGTTGTTTAAATTGTACCATTCATCTTTCA\nACTGATTTAAAAGTTCTTTTATTTCAAGTGAAGAGGCTGTATCAGTTATATTAGCCAGTTGTTTTTGAAT\nTATGTTCTCTTCTTGGGTTAGGGTTAACATATCCTTTTTATATTCGTTCTTAGGAATATCTCCTTCTATG\nAACAGATATTTTAAACGTGCTTTCTTATCTTGGATTCTGTTATATTGTTCTTGTAAATTACTTAACTCTA\nTTGGTTTCTCTTCAGTATCATCAAGATCAACGATGGCGTCTTCCAAGAGGTTTAGAAATTCTTTTTCAAT\nTACATCCTCTGGAACTTGAGGCATATCGCATGTTCCTTTATGATGTCTTGAGCTACACCTATAGCTCATT\nACAATTCTATTATGGCTTCTTACTTGTTTATTTCCCAAAAAATGCTTTCCGCATCTGGCGCACTTTAAAA\nCATTAGAGAATACGAAAAAATTATGCAATCTAACTTTGCCTCTCTTTCTACTATCTTGTACTTGTTGTAC\nAGTATACCAAGTATCTTTATCAATAAAAGTTTCGAAATCCTTTTGAGCAATGTCTGTTAGAATGTCGTCT\nCCCCAGCGGATTTTTCCAATGTAAATCGGATTATTTATAATATAGCGTACAGCATCATAATTGAATATTT\nTCCCTCTCTTAGTCTTAACGCCACGACTGTTTAAAGATTTTACGATGCTTATTATACCTTTTGTTTTAAA\nCATCTCGAATATGTATTTTACAATTTCAGCCTCAGTAGGATTGATATATAAGTTTCCTTTGTTTAGGTCA\nTATCCCATGGGTGATTTAGCTCCGTTTCTCAGACCTAATTCAGCCTTTTTGTGCATGGAATCTCTCACAC\nGTTCTGCTGTTGTCTCTCGTTCCCATTGCGCAAGTGTCGCAACTAAGGTAATAAACATTCTTCCGGTAGC\nGGTTGTTGTATCAAATATCTCTGTGCTACTTTTAAATTTAACATTATATTCATCCATTATTTTTAGAATG\nGAATGTAAGTCTGATACTGAACGAGTGAATCGATCTAATCTATAAACAAGAATAATATCAAATTGTTTTT\nTCTTCATATCTTTTATCATTTTTTGAAAAGCAGGTCGTTCTGTATTTTTCGCACTATATCCTTCATCACA\nGTAATCATTTACAACTACCCATCCTTGTGATTTAGCATATTGCTCCAGACGTAATTGCTGCATATCTAAT\nGAAATACCTTCTTCAACTTGCATATCAGTAGATACGCGTCTATAAATTACACACTTCATTTGCACATACT\nCCTTTCTTAACTAAATTTCTATATCATATGTTTTATCAAAGCAAATTAGACAAATGTATGGGTCAATCAT\nTTGATTGACTATTTGGCCCAGTGAGAAATTCTCACTGTTCATCCAACTGAATGAAATCATATAAATCTTC\nCATATTTACGTTAAGTTGAGAAGCGATATTCTTAGCGGTTTGATAAGACATGATTCTATCATTATTTGCA\nTAAGAATGAACTTGTTGTTTTTTCATATCTAACTTTAATGCTAAATCTACTTGTGTTAATTTCTTCTCTT\nTTAAAATTTCATTCAGTCGGCATTTGCCGACTACATACACTGTTTCACCGCCTAATTATTGAATGATCGG\nACTCACACTGTATAAAAATTTTCCTATAATTCTTATATCCTCGCAGTTATTTTGTGAGTATTGTTGGTCC\nTTAAAACTTTCGTCATGTGAACAAGGTTCTAAAATTATTAAATCTGTAAATTTATACACCTTTTTTAAAG\nTTGCGTAATGTCCATTTACAATTACAGCTGCTATTTCTCCGTTTTGTACATCACACTGTTTTTTCAGTAT\nGGCGTAATGTCCATTAGGAACAATTTTATTCATGGATTCACCGGTAACAACCAGTCCGAATAATTCATCA\nATACTGTGAGTTTTATATGGAGGTGCAATTCTATCAACTACATCTTCTATAGCTTCCAATGGAACACCAG\nCTGCTATTTTACCAATAATAGGAATTTCTTTTTTTAGTTCACACTCTATAGGTTTTTCTTGAACTAATTG\nAAGTTCCCCATCCACAATTTCAACTTTTGTATTCTTATAAGTTGTATCAATATCAGATTTTGTTACTCCA\nAATACAGCGGCCATTTTTTCTAAAACCCCTGAACTTGGTTTGGCTCTATAATTCATATAATCACTTAAGG\nTACTTCTTGCAATTCCTATTTGACTAGCTAAATCAGATTGAGTCATATTATTTTTTTTTAAAAAATTCTT\nTATGTTTCTTACTATGGTTTGTTTTTGTATATCAGTCATACCGTCACCTCCTATTCTGACTACGCTTTTT\nAATATAACATATTACGAATTATTCGTAAAGCGTTATATCCGTATGGTTTTTTCGTATTTTTGTATTGAAA\nTTACATAAATTTAGTAATACAATAAATCTCGAAGGAAGGGGGAAACGAAATGGATTATTTGAAAAGAACA\nTTGAATGAACTTAGGGAAAGCGCAGGGTTCAATCAAGCAGAGCTTGCGGATATATTAGAAGTATCCCCAA\nAAACGCTATGGTTATACGAACAAGATTCAACAAACATACCAGATGAATTAATTAAAAAGTATATGTATTT\nGTTCGATGTTCCGTATGAGGATATATTTTTTGGTTCTAAGTACGAAAAATTCGTACAAGTGAAGAAACGT\nGTACAAGAAAGAGCAAATAATTTAAAAAAAATTGTTTCGTAAAAATTTGCTTTAAATGGGTAGTCCTATT\nGTCCCACGAACATATAAATGCATTGAGGTGATTGAGGATGAGTGGGGGACAAATCATTCGTGATGAAAAT\nGGGTATGTGGTGAAAGTAATCCTTACAAAGGAACAGTGGAAGAAATTTCTAACACCGTTAATACCAGCTG\nCACGGGAGTTAATAATTCAAAGAAAAGTGGAACAACGAAAAAAAGCAAAATGAATAATTTTTTTAATATA\nTTTGCGAAATTTGACGATAAATATTGGTTCTACAAATTAAAGGAGAGTGAAAAGCATGAATGGAGTACTA\nCTAGCAACACGAATTATGAAAGGGCATGAAGTTGTTAAAAAATGCGCAGAAGCAAGAAATAACCCTTTAC\nTATTAGAAGCTATGGAATCAGAAGCAAAACGTAAGTTATACGAAATGAACTGTAAGGTTTCAAATCGAAG\nACCAACTATGAAAAGTCAAGGGGACATTTTCAAAAAATATTGCTAGAGGAGGTGAGTTAATTGAAGGAAG\nTAACGGTAATTTTTAAATCAGGTGCTAAAGCAAGTTTTACAGTAGAGGAATTTGCGACATTTAAAAATGG\nATTTGGAGCTTTAACAAAAATCGAGTATACAGGTGCTAATAAGAAAGTACCCTTCCACATTGGATTAAGT\nAATATCGATGCAATATTTGTGGAAGACATTGGTGGAAAGGAATCTACTAAAGAACCTGATCATCCAATTG\nAAGATTTCTATGGTTGTGAAATTAAGCAAGATGATAAGTATTTTATGTTCGGACAAAATGCCGTGCTTGA\nAGGGAATCTAACAAATTACTTAATTGCGGAACAAAATGTTGAATGCTTTCGAGCTGTATAAAAAGGAAAG\nGGCGGTAAGGAGTGTTGGCAAATGATTTGTTTGAAGAGAAACAACATCTAGTGTTTGCTGCAATTAAACA\nACAATTTGGAAGTATGACAAGGGCTGCGAAAATCGCAGAGTTAAACAATATGGAACTTGATGATTTAATT\nCAATTCGGTCGTATGTATTTATGGGAGCGTTGTTTAAAGCATGATCCAGAGAGAATAGAAACGTTTAGTG\nCATACGTAATGAGAGGTATGAAATGGGCCATGAGTGATGAACTTCACTTGAAAGGGAGCCTGTTTAAGAT\nTAGCAGACGGATTAGTCATGAAGAAAGGAATAAAATCAACATTCATTCGATTGACTATCATCAAGAGGAG\nGAAGAGGTACACGGATTTTATGCTGTGTCTCCTATCGATGTGGAAGAAGAGGTAACCAAACATATCGAAT\nTTGAAGAAGTAACGAGCGTTCTTGAAGAAAAAGAAAAGTCCATCATTATGCACGTTGGTGAAGGGTATAC\nCACAGAAGAGATTGCTGTGAAATTAGAAATGAAAAAATCAACAGTTCATACAACGAAAACACGTGCGTTT\nAAAAAGATGAACCCAGATTATAAGCCAATAAAACAAAAATCCTTTTTCTTGGGAAAGAGGATAATAAAGA\nGAAACCGCCAGTTGGGGCTGACGGTCTAATAAAAACACATGTTGAGGTCATTATAGCATGAATTGATTTT\nGTGTAAAGGAGAGGCTATGTCTTGAAGAACGGTAAAAAGCCAAACAAACGTGAAAAAATTCATATTCAAT\nCACACGATTTAAATCCACAGGATTGGTTGATTTATAAGAAAGTAAATAAGGAATTGCATTTGGTCCATCG\nGACTACTGGTGTAACTCGTATAATTCCAAATTTATAGATTAGGAGAAAGATATAAATGGCTAATGAAATC\nACGCCTAAATTAGTTGCTGATATAACAGATAAAAGTTTTGGCATACAGCTAATTGTTACTGGTCTTGCTC\nACTTAGTAGAGGAAGAGGGATATACACCACATGAAGCATTAAGTATCGCTCGTTACACAGGAAATAATTG\nTTTCCATGCGTTAGCAGAATTGAAGAAGGAGGCTAAAAAATGAACGACAAACCAATTGATGAATTAGTCG\nCGGAAAAGGTTATGGGATGGATAAAACCACCTGAAACATCAATCCTTAAATCAATGTGGGTTTCTAAGCC\nAATAGGTATGGTTCATCGTGAATTACCTAAATTTAGTATGAATATGAAAGATGCATGGTTAGTTGTTGAT\nAAATTACAAGAGTCATTTAAATCAGTGGAAATATTTATTGAAGACAGAATGACAAATGTGATTATAACTG\nAACATTTCCCAAGTGGACATCTAAAAGATAAATATCAGGGATATGAAAGATCGGCTCCTTTAGCTATTTG\nCAAAGCTGCATTAAAAGCTGTAGGGGAGGAATGGCAGTAATGGATATTAAATCAGTTGCTAAAGCTGTAC\nAAGTTATTCGAGAAGCACAAAATGAACATGGAATCATTAGGATTGATGGAAAGGAAGTACATCTAAAAAA\nTGAAGTATTGGAATCATTGTTAGATGAATCTCAGACTAAGCCTTTAATACTAAGACGTGAATCCAAGTAT\nTATCCTTATGAAGTTTCCTTTATTAATGATCATGTAACCTATTTCTCTCTTTACACTGAAGAAAGAATGA\nAAGAGAAAATTGGAGGGATACCAAATGCTCGAAAATTCAATGGTAATCGGGAACCGTCAGGACTCCCCAT\nTCAATAACGTGATGGATCATTGTCAAAGTTGTGGTAAAGAAATCTATTTTGATGAAGAGTACCGAGATAT\nTGATGGTGATTACATACACGATGAAACAGATTGTATCAAACAATATGTAGAGTCTCATTCCATAAAGAAA\nGTAGCTGGTGAGTAAAATGAACGCTGCTATTGAAGAATTAGAAAAGTCATTATATGTGGAGCAAGGGAGA\nTTAAAAGACTATCACGGCAAGCTAGAGAGGGTAATAGAAAGAAAACCAATCCTTGAAAAGAATATCCAAG\nATACTGAAAGCAAGATCCAGGACATTGAAGCTTCAATTTTTGTTCTGAAAAATATGGTGAAGGAGTGAAT\nTAATTGGAAATCACAAATGGTGCTGAAATTATCAAAAGTGAAAAAGCAAAAATTATCATTTATTCAAAAC\nCAGGTAACGGTAAAACAACGGTTGCTGGATTGTTACCAGGTAAAACATTGGTGTTTGATATCGATGGGAC\nAAGTCAGGTGTTATCGGGTTATAAAAATGTAGATGTAGCTAAAATTGATGGTGAAAATCCACATGATAGC\nATTTTACAATTCTTTGCACTTGCTAAAACAAACATTGGTAAGTATGACAACATCTTTATCGATAACTTAA\nCGCATTACCAAAAGTTATGGCTGCTTAATAAAGGTGAAAAAACAAAAAGCGGTATGCCTGAATTAAAGGA\nCTATGCTTTACTAGATAACCACCTTTTAAAGTTAGTAGAAACATTTAATTCATTAGATGCAAATGTTATT\nTTCACAGCTTGGGAGACAACAAGAAATATCACTCATGATGATGGTCAGCAATATACACAATTCATTCCGG\nATATTCGTGATAAAATCGTAAATCACATTATGGGAATCGTTCATGTTGTTGGTCAATTAGTGAAAAAGGC\nAGATGGTACAAGAGGTTTTGTTTTAGAAGGTAATCAAAGTATTTTTGCTAAGAATCATTTAGATCAGCGT\nAAAGGTTGCGTACAACAAGAATTATTAGTGTCATCCACAAACTAAAATACAGGGGGAAATAAACAATGAG\nTTTTAAATTTAAATTTGATGAAGAAAATGTATCACAAGGGTTTGGATTGGTAGAGGAAGGTAAGTATGAA\nGTTACAATTATTACTGCTGAAGCAAAAGAATGGCAAGGTCAATATTCTATTGGATTTGATGTGGAAATCC\nGTTCAGATATTGAACAAAAACATCAAGGAGCAAAAATCCTATATAACACTCTATATCTAACTACTAACAT\nTCAAGAATATGCAGAGGACACGGAAAGAAGACGTAACTCATTCTTAAAAGCTTGCGGATACACAGGTAAA\nCAGGATTTGGAATTAAATGTTGTTGTACGTGAGATTGTAGGTAAAACGGTTTTAGCTTATGTAAAACATG\nAAACAAATAAGGATGAAAAAACATTTGCTAAAGTTAAATTTGTGGCACCATCGAATGTAAAGCCGTCTGA\nACCAAGTGGACCACCGATTACTGTTGGCGATGATGATTTACCATTCTAAATAACTAAATAGAGAGGTCGG\nTTTTGTCGACTTCTCTTTTTTATACCCTAAAAAGTTAATTGGAGGGCGCAATGAAAGAAAATCCATACAA\nTTTTAATGAAATTCCTGCTGAATTAAAGGGCCTTCCCCAGTGGATCTTATGGAAGCTTGAAACCAGAAAT\nAATAAACAAACAAAAGTACCCTATCAAGTAGATGGAGAAATGGCCCAAGCAAATAATAGACGTACCTGGT\nCAACATTTGCAACGGCAGTCAAATTTTATTTAGAAGGTGACTATGATGGAATCGGGTTCGTGTTTAGCAG\nGCAGGACAATTACATCGGAATCGATATTGATAAGTGTGTTACGGACGGAAAAACAAATGCTTTTGCAACG\nGAAATTATCGATACATTAGATAGTTATACGGAGTTTTCACCTTCAGGAAAAGGTATCCACATCATTATCA\nAAGGGAACCTTCCACAATCTGTTTTAGGTACAGGACGAAAAAATACAAAGCACGGTTTAGAAATTTACTC\nATACGGACGTTTCTTTACCTTTACTGGAAATCGTGAGAATTCCAATGATGTATACGAGCGAACGGATGAA\nCTAGCTGAAGTATTTGAAAAATATTTTGATGATAGCGACATTCAAGGTCGTGTAAATTTAGCAGAGTTTG\nAAAAAGATGAAATCAAAATTTCGAACGATGCTCTATGGGAAAGGATGTTTAGAAGTAAGAATGGTGATGA\nAATTCGCTCGTTATACAATGGCAGCTTAATAAATGATGATCATTCAGCAAGTGACCTTTCTCTATGTAAT\nCATTTAGCATTTTGGACAGGGAAATCAGCAATTCGAATGGACTCCATGTTCCGTGAGTCAAGCCTTATAC\nGTGATAAATGGGACGTTATTCATTTTAGCGATACAAATGAAACATACGGTGAAAGAACGATAGCAACAGC\nCATTTCATCTACTTCCACAACTATTTTAGATAACAAACAGCAATTCGAAGAATTTTCTTTTGATTTCATG\nAATGAAGATGCGGTTGAAGTTGTGGAGGACAAACCGAAAAAGAAATTCCGTTTAACTGAATTAGGAAACG\nCTGAACGTATCGCATATGAATATGGCCATGTAATCAAATATGTTAGCGATATTGGCTGGTACATATGGGA\nCGGTAAACGCTGGAAGTTGGACACGAAAAAAGAGATTGAAAGAATTACAGCAAAAGTACTTAGAAGTCTT\nTATAAATCAGAAGATGAATTAGAAACAAAATGGGCTCGAATGTGTGAACGGAGAAATATTCGTATGAATA\nGCATTAAGGATCTTATGCCATTGGTTCCAGGTGAGCGTGAGGACTTTGATAAGTATAAATACTTGTTCAA\nTGTTGAAAATGGCATTGTTGATTTAAAAACAGGAAAGTTGCAGCAACATGATCGGGAACTTGGTTTAACT\nAAAATTACTAATATTTCATTTGATGAAAATGCAAAATGTCCAGAGTGGCTTAATTTCTTAGATCAAATTT\nTCCAAGGTGATAAGGAACTAACTGAATACATGCAGCGGTTAATTGGTTACTCACTAACAGGGGAAATCAC\nGGAGCAAATAATGGTCTTCTTAATTGGTGGAGGTTCCAACGGAAAATCGACCTTTATTAATACCATTAAG\nGACCTTTTGGGTGAATACGGTAAACAAGCAAAATCAGATACTTTCATCAAAAAGAAAGAAACTGGTGCCA\nATAATGATATTGCTAGATTAGTAGGGGCACGCTTTGTATCTGCAATCGAAAGTGAAGAGGGTGAACAACT\nCTCAGAAGCTTTTGTAAAACAAATAACAGGCGGTGAGCCAGTATTAGCACGTTTCCTTAGACAAGAGTAT\nTTTGAATTCATACCAGAGTTTAAAGTGTTCTTTACAACAAACCATAAACCAGTAATTAAAGGTGTAGATG\nAAGGTATTTGGAGACGTATCCGTTTAGTTCCATTTAACCTGCAGCTACCAAAAGAGAAACGTGATAAGAA\nATTACCAGAGAAAATTAGCTTAGAAATGCCAGGAATCCTGAATTGGGCAATTGAGGGTTGCTTGAAGTGG\nCGGAAGTCGGGACTAAACGATCCAGCAATTGTTATGAAAGCAACAGGTGATTATAAAGAGGAAATGGATA\nTTCTTGGTCCGTTCATGTTTGAATGTTGTTTTAAAAGAGAGGATGTCCAAATTGAAGCAAAAGAATTATA\nTGAAGTTTATGCGAATTGGTGTTTTAGAAATGGTGAACATCAATTAAAAAATAGAGCCTTTTACCGAATT\nTTAGAATCCCAAGGATTCAAAAGAGAACGTGGCAGCAAAAACAAGTATTACATCAAAGGTGTTACTCTAA\nCCGACCGAAAAAATACTTTTAAGCAGCAAAAGTTACTGAATTTCGATGAAAATAGCAAAAGTGTTACTAA\nAAGTAACCCATTTAAAATCACTTAAAACCCTTGATACATAAGGGCTCAAGATACTTTTTATATTCCTTTT\nGTTACTTTTGTTACTAAAAAATACTATAAACAAAAAATAAATATATATATAAGTATTCTATTAGGAGCTT\nCTTTGAACTTTTTAGGTAACCTTAGTAACCCGAAAGTAGCATGAGCCGTTGGGGCTGTAAGGCTCAAGGC\nGTGTTACTAAATGAAAAATAAGAGTAATTTATGGTGTTTTTTAAGTAAAAAACGGTTATTTAAGTAACAC\nACTTAGTAACGGAGGTTGTATTAAATTGGAAAAACATTATAAAGAACACGGGCTAGAAGATTTTTGGAAA\nTTTAAAATTATACGATCCAAGAAAAATGAAATTGGTTGTTCAGAAACCTATGAAAAATATAAAAAATGGT\nGCTATGAAAACAATACTATTCCGAATAAAAGAATTACATTTTTAAGATTCTTAGAAACAAAAGGGTTTGA\nAATTGTGAAGAGCAAAAAAGAACCATTGTATTTTAAAGGAATGAAGATTAAATGGTGAAAGTTTTATTAA\nTTTTAAGTGCGATTTGGAAATCAGGTGCAGATATCTATCTTGATAAAAAGGATAATCAAGTTGCGATAAA\nAAAACAAAATTTAATTCCAGCGGAAGTAATGAAAGCCGCTGAACAAAACTATCAAGCTATTTATGATTGG\nTTTCAATCTTGGAAAGATGAGAGTGCGGAGAAAATTACGTTAATGAAGATATTTCATCATTTTTGTGGGT\nGGAAACATAATCAAAAATTACACAATTGGTTAGTTGAAGAAGAAGATTCATTGCAACTGTTTTATGAGTG\nGACGATTGTCCTTGCTAATAATGGTTGGACAGATGTTTATGAGGATCATCGTCAGTTTGAAAATGATGAA\nTCAAATGCAATGGCAAGAAAGATATATGAACGTGCGGTTTTATATGCAAGGAAAGGGGCATGAAAATGAG\nAGAGATAAAATTCCGTGCTTGGGATGGAACGAGTTGGGTTTATAGCGAATGTATATCAAAAGATGGTATT\nAATTGGTGGATATTAAATAATGAAGATGATAATTGGTTGACGTGTTTAGATCCACAGCAATATACAGGTT\nTAAAAGACAAGAACGGTAAGGAGATTTATGAAGGAGATATTACAAAAGACAAGTTTGGTAATCTTGATGT\nTATTTGTTGGATTAATAGTTCAGGTGCATATGCGACTGTGTCGATTAATTTGTATTTAGACGGAGAGTAT\nGAACATACGGTTGTTGATGAATTTGGAACGGATTGTTTCTTTGAGAATAATGTTCCTGGTGATTTTTTAG\nAAGTAATCGGAAATATCTACGAAAACCCAGGGTTACTGGAGGATTCAAAATGATTCGTTTCCATTACACA\nGATAAAGAAATAGAAAAAATCCTTAAAACACTCACTATCGTTATCGATACTCGTGAAAATGTAAATGACC\nACATTCGTGATTACTTATATCAAAAGGGCATCCCAATTAAAAATCAAAAATTAGATACCGGTGATTATGG\nTTGCATGATTCCCAAAAATGAAGAGTTAGGAATACCACGTGATATTTATTTAGATCGTCGGATAGAAAGA\nAAAATGAGTATCGATGAAATTACAAGTAACCTACAAAAAGATACGCAAACAAGATTTGAAAATGAATTGA\nTTCGATCGAAGGATATTCCATTCACTTTAATTGTGGAAGATCAACGTGGTTACGAGAAAATACTTAAAGG\nTGATTATAAATCAAGATATAACCCATTGGCATTACTCGGTAGGCTTAATACTTTTAAAGCAAAATATGAT\nTTTGAAATAGTCTATCTAGATAAAAAGTTTGTTGGTAATTGGATATATTATGTCCTTTATTATCATGCAA\nAACATTATCTTAAAACAGGTGCATTTTAAGTTCAGAAACGTACAGAAATAACAGAAAAACTTTAGTTCTA\nATATCAATTTAATATAAAAGGAGTCGGAAGACATGACAAAGGTAAAATTGAACGTATTATTCAAGAAAAT\nGCAAAAGGATGATAAAAAGGAAGTTTTGATGTTCCACGTATTAAGTGATGAATTACCACATGCTGATGAG\nTTATTGAAGATGCCAGGTACTATTGTTTATCTAACTGTGGAAAAAAGCGATGTTGAAGCAATTGGTGCTG\nAATTTGTTTCTATTCAACGTGATAGTAAGAAAACCGTTCTTAAATTCAATGTAAAAGGCGATACGAAAGA\nTAAAATTAATAAACTTTATCCATTCGCTGGTGAAAATGTTTCTATTACTCTAGAGCCTTCGCAAATGTCG\nATTGATGAGTTTTACGAAGAACAACATGAAGGAGTGGAGTATAACGTTAATCCTGATGGAACAACTGATG\nTTGCTCCGGGGCAATTGAAGATTGTTGATGAAGAAACGATTGCTGAATAAAAATTTATCCTGGGCTTCGG\nCTCAGGATATTAATACATTTTGAATTTTGTTAAGAAATGAGGGTAACTTTTGAAAATTATAAAAGATGAT\nAAGAAGTGCCAAACATGTATTTTCTATGGTTTATGCACGAAAGCGCACTTACCACACTGCCTAGGAAATG\nATTACTTCAAAGACAGTGTCCAAAAAGAAAAATAAAACTAAAGCTAAAGCGTTACTTTAATCGGAAATGG\nCAGGTAATTGACCAAATCACCTGCCATTTGCCTAAACAGTCCGGAGGGGTAAAGCTCCGTTTTGAAAGAG\nTGTAGCCGACTCGTAGATAGTATGTGTAATGTAAAAAAGATTATTCGTATATCACACGGGATATGAAAAG\nGAGAATGAAAAATGTCTAACAAATTTGATAAGGACTTTGAAGCAATTACGAATAATGGTGAATTAACGAA\nAGAAGGAACAGAATTTATAGAAGCTGTAAAGCAATTCGTCGGTACGCAATATGATTCAGAGGATTTAGCG\nAAATTAATGGTATTAATTATGGCTGCTTTAGATGTGGATGACAATGCTTTTAATACAGCGATATCCGCTT\nTATATCAAACTGCAATAGAAGTGCAAACAGGTATCAATCTGAATGAATTACTGGATTTAGTGACAAAAGG\nTGAACCAGGCTTAACTCATTAGGAGAACCCAATGTATTCGACGAGTTTCGACATGAAAACGACCGTCAGA\nAACATAGTGATTTGAAGTTTTATTTCTTTCTGAATACAAATAGGTGCACAAGTGTTAAAACGTCTTAGAA\nAGGAAAATAAACGTGTTTTATGAGATGTATTGTTTTTTATAGAAAGTAGGTGAATCATCATTTGTTTGAC\nTGGCTAAAAGACTATCAGAAATTAGAAGAAGACATTGAGTACTTAGATTACAACTTAGATAAAACAAAAG\nCAGAATTAAAACGCTGGGTCAGTGGTGATTTGCGAGAGGTACGTTTAACTGCTGAATCGGAAGGTGCAAA\nGGTAGAAGAACGTATAGAAGCAATTGAATATGAGTTAGCGCACAAGATGAATGCAATGCAGGATGTATTG\nAAATTGATAAATAGGTTCAAAGGTTTAGAAAATAAAATGTTAAAAATGAAATATGTGGACGGAATGACAT\nTAGAAGAAATAGCTGAGAATATGAATTATAGTTCTAGTTATATCTATAAGAAACATGCTGAAATAATAAG\nGAGAATAAAGTTTGCTGAAGAACTTGCACTTTACTGACACCCAGTTTTATGAATGTTAACTCTTGAAGAT\nATCGATTATAGTAATAACATAAGAAATTGACGAAAGGGCAACTGGTGCACAGTTGCTCTTTTTAATTAAA\nCAAACCATATCCATATAATAATGATAACAGCAAAGATAATGATTAGTATTTGTGAGAATTTCATAACATG\nCTCCTTTTAAACTATAGTGTTTGCAAAGGATTGAAGAGGCATTCCTTATGGAGTGTTTTTTATTATGTAA\nAAATTATATAGGTGGTGTAGAGATGACTTTAACGTTGCATAATGGAGATTTGAATAAGTTAGCAAGAGAT\nACTTCACAGGACAGTATCATCTTGAGAGTTGGTGAACAAGAAATGGTATCTCTGAAAAGCAATGGAGATA\nTCTATGTTAAAGGTAAGCTTGTTGAAAACGATAAAGAAGTTGTAGATGGCATGAGAGAGTTATTGATGTT\nATCTAGGAAAAGGTAAGCGCAAACGTGTTGCATTTTATAAGGATGGTGAAAAGAAGATGTTCTCATATAA\nAAAACGTATTGAATCCTTAGATGAACTTCATAAAGTTATTGATGCATTAGAAACGTTAAAGAAGGAGTAT\nCAGATTATCAAAAAGATAGAATGGTCGGAACCTAAATCACCTCTTCCTAAATTACCAAAGAATGTTTGGT\nATGTTGAAGAAGTTGATACATCTAAAATCTTTTTTACTGATGCTGATGCAATAGTTAAATTAGTTTGTAA\nAAATTGTGGAATATCGTGTAGAGGGAAAAGAAATCTATTAGAAGGAATGAGTTGTATTTATTGCTTTAAT\nCACAATACAACAATAGTTTCTTTAGATAAGGAGTTTGAATGTAAATGAAAGTAATTATGGGTGAAGAACC\nTTTATTACCTAATGGAAAAAGAAATGGAGAAGCTGTTAGAAGTATGCTTGATAAAATTAGGTCGCAAGAA\nCAGAAAGATAAGGAGAGTGAATGCAAATGATTACTGAAATTAGAAAAACAATATCTGGTACAGAGTATTG\nGGATAACAAAGAAAAACGAAGTCTATTTGTTCCTACAGATGAAGAACCAGGATTCGAAGTAACTGTTAAT\nCCTGAGAGTATGATCTTAGGCATGGACATATCAAGTGAACCTGATAAGACAGTAGTTAATTTAAATGGTA\nTGACAGTGAAACAATTACATGAATATGCTGCATCGATTAATGTTGAGATTCCAGCCGATGTTAAAAAGAA\nAGAAGACATCATTGATTTACTATCATGAAGTACTGTGCTGAACAAGGCTGCAAGACATTAATCGATAAAG\nGACGATACTGTCTCAATCATAAACGTAAACAGAAGAAGACAGTTGTGTATTCAAAGAACAGATCATTCTA\nTCGTACAAAAGCCTGGCAAGATTTAAAGTCATTCTGTTATCAAAGAGACAAAGGATTGTGTCAACGATGT\nGGAAGGTTTGTGTTTGGTAAGCAAGCACATCATCATCATATTGTTCCAATTAAAATCAATCCTTCATTAA\nGATTAGATCCAGATAATATCGATACACTTTGTTCTAAGTGTCATCCGATTGTAGAAAGAGAAACAAATGA\nAAAATACCAGGAAAAGAAAAAGTTCGACTGGAAACTATAAGCCCCCCCTATCAAAAAAAGAAAAGCTGGC\nCTTATGGGGGGATAGGGAGTGGGGGTGCAAACGCGCACCTCAAAATGGTTTTTTGAAAAAAATTTGTTTT\nTTTTAGGTGGTGATTTAAGGAATGGCCAGAAAATCGAAGGTCGTAATTGAAGCTGAAAAGAAAAAAGAAT\nTAGAAGCGCAGCGTATTATGGATGTTTTGGTTGAAGCCGGAACTTATTCGCCAGCGCTCGATCCATTAAT\nTGAAGTTTATCTTGATGCAGTTGAGATATACAGCGTCAAATATGGATTGTGGAAGAATTCTAATTTTCCA\nACAGTCCAAAAAACAAAGAATGTAAATGGTGATGTGAAAGAATCAAAGCATCCATTAGCTCAACAAGTTG\nAAGTTTGGTCTAAGCAAAAAGCGAAATATTTGGGGCAATTAGGACTGGACGGAAAGAACAAAGATTTACT\nTAAAAAAAGTGGGGTTCTTCTCGAAAAAGGAAAAAATGAAAAAGAGCCCACGGAGTCTACTGATAACAAC\nAAATTATTGCAATTTAGGCAGAGGTTAAATAGATGATTGATTTTGAAACAAATTACGCTGATATATTCGT\nTTCGGAAGTAGATGCAGCCCCGCACTTATATCCTGATTCAATTAAATTAGCAATCAAACGATATAAGAAA\nTGGAAGAAACGAAAAGATATTTGGTTTGATGTTGAAAAAGCAAATGCTATGATTTATTTCACAGAAACAT\nTCTTAAAACATGCAAAAGGAAAATGGGCAGGACAGCCGTTAATTTTAGAATCCTGGCAAAAGTTCTACTT\nTGCTAACATTTATGGATGGCAAAAATATAATGAAGATGGTAAAGCGGTGCGAGTGATTCGTACGGCTTAT\nTTGCAGGTTCCAAAGAAAAACGGAAAAACAATCATGGGCGGTTCACCTGTTATTTATGCGATGTACGGTG\nAAGGTGTAAAAGGCGCAGATTGTTATATTTCCGCTAATACTTTTGAACAATGTCAAAATGCAGCTGGACC\nAATTGCATTAACTATTGAAAATAGTCCAGATTTACGGCCAGATACACGTATCTATAAAGGCAAAGAAGAC\nACGATTAAATCAATTAAATACACATTTGTGGAGGATGATATAAAATATGCAAATGTAATTAAGGTTTTAA\nCGAAAGATAACGCTGGTAATGAAGGTAAAAACCCGTATATTAATTATTTTGATGAAGTTCATGCTCAAAT\nGGACCGTGAACAATATGATAACTTACGTTCAGCACAAATTGCCCAAGAAGAACCACTCAACATCATCACT\nTCCACAGCAGGGAAGAATACCGGCTCGCTTGGAACTCAAATTTATACCTATGCAAAAGAAGTTTTGGATA\nAGGATAAAGATGATTCTTGGTTCATGATGATCTATGAGCCGAATAAAAAGTTTGATTGGGAAGACCGTGA\nTGTTTGGCGAATGGTTAACCCGAACATGGATGTATCAGTTAACATGGAGTTTCTTGAAAATGCATTTAAA\nGAAGCTCAAAACAACAGCTTTAATAAGGCGGAGTTCTTATCAAAGCATTTAGATGTATTTGTTAACTATG\nCTGAAACATATTTTGATAAAGACCAATTGGATAAAATGCTTGTTGATGATTTAGGAGATATTGAAGGTTT\nAACTTGTGTTATCGGTGTGGATTTATCAAGACGTACCGATTTAACTTGCGTATCGTTAAATATTCCAACA\nTACGATGAGGAAGGTCTTTCATTGTTAAAAGTAAAACAAATGTATTTTATTCCAGAGTTTGGAATTGAAG\nATAAAGAACAGCAAAGAAATGTTCCATATCGGGAATTAGCTGAAAAAGAATTTGTGACGATTTGTCCTGG\nTAAAACGGTTGACGAAGAAATGGTCAATCAGTACGTTGAATGGGTATTTGAGAACTTTGATTTACGTCAA\nATTAATTATGATCCAGCGCTTGCTGAAAAGCTTGTTGAGAAGTGGGAAATGCTCGGTATTCAATGTGTGG\nAAGTTCCACAGTATCCAACTCATATGAATGAACCATTTGATGATTTTGAAATCTTATTGCTTCAGGACCG\nAATTAAAACTGATAATCAATTATTAATTTATTGTGCAAGCAATGCAAAAGTAATAACTAATATTAATAAT\nTTAAAAACACCATCTAAACGAAAATCACCGGAGCATATCGATGGGTTTGTGGCCATGTTAATTGGTCATA\nAAGAAACGTTGAATATGATGGAAGATGCTGTTCCAGATGAAAATTATGATGAATATTTAGATGATATTTA\nTCGATAGAAAGGCGGTGAGGAATTGGGTTTAAAGGATAGATTTTCAAGTTTTTTACTTAAACAAGCTGAA\nAAGCGTGGTTTATTCGAAGACATTTTCAATAATGTTGTTCGCTATGGTGGTAGATATGCAGGCGATGATA\nATATCTTGGAATCTAGTGATGTTTATGAATTACTACAAGATATAAGTAATCAAATGATGTTGGCTGAGAT\nTGTTGTGGAAGAAAAAGACGGTAAGGAAATTAAAAATGATTCAGCTCTTAAGGTTTTAAAGAATCCAAAC\nAATTATCTTACACAGTCTGAATTCATTAAGTTAATGACTAATACCTATTTACTTCAAGGTGAAGTCTTTC\nCAGTGTTGGATGGTGACCAATTACATTTAGCATCTAATGTTTATACAGAATTGGATGATAGATTGATAGA\nACATTTCAAAGTGAATGGAGAAGAAATTTCATCATTTATGATTCGACATGTGAAGAATATTGGTGCCGAT\nCATCTAAAAGGTACAGGCATTCTTGATTTAGGTAAGGATACACTTGAAGGTGTTATGTCAGCTGAGAAAA\nCTTTAACTGATAAGTATAAAAAAGGTGGTTTATTAGCATTCTTACTTAAGCTAGATGCTCATATTAATCC\nACAAAATGGAGCGCAGTCCAAATTAATTAAAAAGATTTTAGATCAATTGGAATCCATCGATGATGCAAGG\nTCAGTTAAAATGATTCCACTCGGAAAAGGATATTCAATAGAGACGCTTAAAAGCCCGTTAGACGATGAAA\nAGACCCTGGCCTATCTAAACGTATACAAAAAGGATTTAGGTAAGTTTTTAGGCGTAAATGTGGACACATA\nTACGGCCTTGATTAAGGAAGACCTTGAGCAAGCAATGATGTATTTGCATAACAAGGCAGTTAGACCGATA\nATGAAAAACTTTGAAGACCATTTGAGTCTTCTTTTTTTCGGAAAAAATTCGGATAAACGTATTAAATTCA\nAGATAAATATCCTTGATTTTGTTACTTATAGCATGAAAACAAACATTGCTTACAACATTGTTCGAACTGG\nTATTACTTCACCAGATAATGTTGCGGATATGCTTGGATTCCCTATGCAAAATACACCTGAGTCACAAGCG\nATTTATATTTCAAACGACTTATCAAAAATTGGTGAGAAACAAGCTACAGATGATTCACTGAAGGGAGGTG\nATGGAAATGGCAAAGACAAAGGAAACACGGACATTTGACATCACCAAATTAAGTACCAGGGATGCTACGG\nAAGAACAACCTTCCAAGATAACGGGTTATGCAGCCGTATTTAATTCAAAGACAACTATTGGTGGCTGGTT\nTGATGAAGTTATTGAACCTGGTGCATTTGCTCGTTCTCTTTCTGAGAATGGTGATATTAGAGCGTTATTC\nAATCACAATTGGGATAATGTCCTAGGGAGAACAAAAAGCGGTACATTGAGACTAGAAGAGGATGAAAAAG\nGACTTAAATTCGAAATTGAATTACCAAATACATCTGTTGGTCGAGATTTAGCTGAAAGTATGTCCAGGGG\nAGATATTAACCAATGCTCATTTGGATTTTGGATAACAGAAGAGAATTGGGATTACAGTGTTGAACCAGCA\nTTAAGGACCATTAAAGAAGTAGAACTTTATGAAATATCGGTTGTTTCAATACCAGCTTATGACGATACGG\nAAGTATCTTTAGTTCGCAGTAAAGAGATTGGTAAAGAAATAGAACAACGAATGAAAATGATTAAACAAAT\nAAATCAAATCTTGGGGGAAAAGTAAAATGAACAAACAATTATTATTAGCATTACAAAAACGAAGCAATGA\nAAGATTAGTGGAATTACGTACACAGGTTGAGAATCCTGAATTACGTGCTGAAGACTTACCAGCAATTCAA\nGAAGAAATCGATGAAATTAACAAGCAATTGCAAGAAGTTGCGGATGCTTTAGCAAATCTTGAAGATGATG\nGTGGAGGTGAAGAAGGAAACGAAGATAATGAAGAAGGTGATGAGGGATCTGGTACTGAAGGTTCTGGAGA\nAGGCGGAGAAGGGCGTGCTAGCAATACTGAAGGTGGAGAAAATAGAAATGGATTAACGCCTGAACAAAGA\nAGTGCAGCAATGGCAGCTATTGCAACAGGTCTTTCTACTCGAGGCCATAAATCTACTAAAAAGAAAGAGA\nAAGAAATTCGTTCGGCATTTGCTAACTTTGTAGTTGGGAAAATTACAGAAGCTGAAGCGCGTTCTCTTGG\nTATTGAAGCTGGTAATGGTTCAGTAACTGTGCCAGAAGTTATTGCGAGCGAAATCATTACTTATGCTCAA\nGAAGAGAACTTACTACGTAAATATGGTTCAGTTCATAAAACAGCAGGTGATATGAAATATCCTGTTCTTG\nTTAAGAAAGCAGATGCAAATGTACGTAAGAAGGAACGTAAAGATAGTGATGAAATCGTAGCAACAGATAT\nTGAATTTGATGAAGTGTTACTTGATCCAGCTGAGTTTGATGCACTTGCTACTGTTACTAAAAAGTTATTA\nAAAATGACAGGTGCTCCAATTGAGCAAATCGTTGTGGACGAGCTGAAAAAGGCTTATGTTCGTAAAGAAA\nTTAACTACATGTTCAATGGCGATGATGTAGGTAATGAAAACCCAGGTGCGTTAGCAAAAAAAGCGGTAGC\nGTTTAAGCCTTCTAATCCAGTTGATTTAAAAGCAAAAGATGCAGGGCAATTAATGTATGATGCATTAGTT\nGAAATGAAAAATACACCTGTTACAGAAGTAATGAAAAAAGGACGTTGGATTATTAACCGTGCAGCATTAA\nCAGCAATTGAAAAAATGAAAACAACTGATGGATTCCCATTACTACGTCCAATGACACAAGTAGAAGGTGG\nTATTGGAAATACGCTTATTGGCTATCCTGTGGACTTTACTGATGCGGCAGACGTAAAAGGAAAACCAGAC\nGTTCCAGTTTTATATTTTGGTGATATTTCAGCGTTCCATATTCAAGATGTAATTGGCGCTATGGAATTAC\nAAAAATTGATTGAAAAATTTGCTGGTACAAACAAAGTTGGATTCCAAATTTACAACTTATTAGATGGTCA\nATTAGTTTATTCTCCATTTGAGCCAGCTGTGTATCGTTTTGAAGTGCAAGCTACAACTGAAGGTAAATAG\nGTTATGAATGATTTAATTGAGAAATTAAAATCTCATATTCATTGGGAAGAGGGTATGGATGAAACCATGC\nTCTCTTTTTATATCACTCAAGCAAGGACTTATGTAAAGAATGCGACAGGCAAACAGACCGAATATCTAAT\nTATTATGGTCGCCGGCATTTTCTATGATTACAGGGTCGCTGAAAAAGAATTAGAACAAGCTCTTGATGCC\nTTAACACCAATGTTTGTCCAGGAGGTTTATGCTGATGAAGAGAAAGACGAATAAACTCAAATGGATGGGT\nGAGCTACTTAAATTAGGAGAAACAATTGATCCGGAAAATGACCGAGTTGTTATGGGATATCCATTAGAAC\nGGAAAATTCGTTATAACAACATTGGAGTTACGGCTACTGATAAATTTACAACGAAAGATACGAATGAAAT\nTGTAAAGAAAATTGAAGTTCGTATTGATCGAGATATTGAAAACGATCAAAAGGATTATCGTGTAAAAGTT\nGGTGGCCGTATTTATAACATTGAGCGCATTTATGTGAAAGAAGAAGATCGATTGATGGAGGTGTCACTAT\nCGTATGCAAATTAGTTTTGAACAGTTGCGAAGCCTTATGAAGAAATCTGGTATTCCAGTTTCTCGTGATA\nGTGCTCCTACAGGGATTGATTACCCTTATATTGTGTATGAATTTGTGAATGAGCAACAGAAAAGAGCTTC\nTAATAAGGTTCTAAAAGATATGCCACTTTATCAAATTGCTGTTATTACAAATGGAACTGAAAAAGATTAT\nGAGCCGTTAAAGGCTGTTTTTAACGAAGCAGGCGTGTCTTATTCTCAATTTGATGGAATGGGTTATGACG\nAGAATGATGACACTATCACGCAGTTTATAACGTATGTGAGGTGTATCCAGTAATGGCTTCAAATAACAAT\nGGTTTTGCTGAAGCTTTAGAAGATATTAATACGCTATTACGATTGAATAAAAAGGTCGAACTGGATGTAT\nTGGACGAAGCAGCGAAGTATTTTGCGAGTAAATTAAAACCAAAAATTAAAGCATCCAGTAAAAACAAGCG\nGACACATTTAAGGGATAGCCTAAAGATTGTTGTGAAAGATGATCGTGTATCTGTGGAATTTAAAGATGAA\nGCTTGGTATTGGTACTTAGTTGAACATGGCCATAAAAAAGCAAATGGTAAGGGACGTGTGAAAGGAAAAC\nACTTTGTTCAAAATACCTTTGATGCAGAAGGTGACAAAATCGCTGATATTATGGCACAAAAAATAATTGA\nTAGAATGTGAGGATGATATACATGACAGTTGAAAATAAAGAAATTCAATATTCTGTAGGGATCGAAGATT\nTATATCTGTGCTTGATGAAGGGAAATGAAACTTCTAGTGCACTACCAACTTATGAGGATATCGTTTATAG\nACAAACGAATATTTCTGATTTAACGATTTCCACTACTTCTACTAATTTTACAAAGTGGGCATCTAACAAA\nAAAATTATTAACATTGTCAAAAATACAGCGTTTGGATTAGCTTTTAATCTTGCTGGTCTAAATCGTGAAG\nTAAAAGATAAAATCTTTGCTAAAACACGTAAAAAAGGTGTGTCTTTTGAAACAGCGAAGGCGAAGGCGTA\nTCCAAAGTTCGCAGTAGGGGTTGTATTCCCTTTAAATGATGGAACAAAAATATTACGTTGGTACCCAAAA\nTGTACAGTTGCTCCAGTAGAGGAATCTTGGAAAACACAAGGTGATGAAATGACTGTGGATGACATTGCTT\nACACAATTACAGCAGATCCATTGTTATTTAATGATGTAACACAAGCTGAATTGGATACTGGTGATCCAGA\nGGCAAAAGGAATTAAAGCTGAAGATTTCCTAAAACAAGTCATTTGTGATGAATCTCAACTAGCGCAGCTA\nGGTGGAACGACTCAAACAGGTAAATAAGGAGGGTGACTATGGCACGTTTAAGTGATTTAGTTAACGTTAA\nTATAACTAGGAATAGCATTAAGATACAGGGTGTCTCAATCCCTGTTATTTTCACTTTTGAATCTTTTCCT\nTATGTGGAAGAAGCATTTGGAACACCTTATCATGAATTTGAAAAAGAAATGAATGATATGTTAAGGAAAG\nGTCAATTTAGCCTGGGAGAAAATGAAGCGAAATTGATGCGTGCATTAATTTATGCGATGGTACGTAGTGG\nTGGTACGGAATGTACATTAGATGAATTGAAAGGTGCTATTCCTATGAATGAATTACCTGATATTTTCATC\nGTTGTATACGAAATTTTCAGTGGCCAAACTTTCCAGAATTCTGATATGGAGAAGTTGAAGCAAGAAAAAA\nAGTAAAAAACATACTGACTAAAAACGAGGAATCTCAGTCCGAATTGGACTGGGATTTTTATTTTTATGTT\nGGTAATACGTTGCTTGGTTTAAGTATGAATGACTTCTGGAAAATCACACCTGCACATTTTTTAAAGCAAT\nTCATCATGCATCTCAGATACAACAATCCGGATGCGTTACATGAGCAGAAAACGAAACAAATTTACACGCT\nAGATCAAACACCATTCCTATAAGAAATGAGGTGAGAAAATGCCTGGGAATAGTAAAGAAAGAAACGTTGT\nTCTTAATTTTAAAATGGATGGCCAAGTTCAGTATGCAAATACATTGAAACAAATCAATATGGTTATGAAT\nAATGCAGCGAAAGAATATAAAAATCATATTGCAGCAATGGGCCAAGATGCGACGATGACTGATAAACTTC\nTTGCTGAAAAGAAGAAGCTTGAAATTCAAATGGAAGCAGCTAAAAAGCGTACAGCTATGTTGCGTTCTGA\nATATCAAGCGATGTCCAAGGACACAAGTACAACCGCTGAACAACTCAATAAAATGTATGGAAAGTTACTT\nGATGCAGAACGTGCTGAAACTACTCTTAATAATGCAATGAAAAGAGTGAATGAAGGTCTTTCAGAGCAAG\nCCATTGAAGCACGAGAAGCACGTGGAGACATGGAGAAACTTGAAGCTAATACTAAACAACTAGAAGCTGA\nACAAAAGCGACTAACAAGCTCGTTTAAGCTTCAAAATGCCGAACTAGGAGCGAATGCTAGTGAAGCTGAT\nAAGTTGGAATTAGCGCAAAAACAATTACGTCAGCAAATGGAAATGACAGATAGAGTCGTCCACAATTTAG\nAACAACAGTTAAGTGCAGCAAAGCGTGTATATGGTGAGAATTCCACAGAAGTACAGCAACTTGAGACGAA\nGCTAAACCAAGCTAAAACCACGTTGAAGCAGTTTGAGAATTCATTACAGAGTGTTGGTCGAAGTGGAGAT\nCAAGCAGCAGATGGTATGGAGAAATTAGGAAAGAAGTTAGACTTGCACAATATGATGGAAGCTGTCCAAA\nTGCTACAAGGAGTATCACAACAGTTAATTGAACTTGGTAAAGCTACAGTGGGTATAGCGATAGATTTTGA\nTAGGTCACAAAGGAAAATACAATCCTCATTAGGGCTAACTCAAAAGGGTGCAGAGAATCTTGGCAAGATT\nTCAAAAGATGTGTGGAAAAAGGGATTTGGTGAAAGCCTTGAAGAGGTCGATAATTCACTGATTAAAGTCT\nATCAAAATATGCGTGATGTTCCACATGAAGAATTACAAGGGGCATCAGAGAATGTTTTAACATTAGCTAA\nAGTTTATGATGTGGACTTAAATGAAGCAACTCGTGGCGCAGGACAATTAATGTCTCAATTTGGTTTATCT\nACACAACAAACATTTGATTTATTGGCAGCAGGTGCTCAAGCTGGGTTGAACTATTCTGATGAACTCTTTG\nACAATCTTTCAGAGTATGCACCGTTATTCAAACAAGCGGGTTTTAGTGCGGATGAAATGTTTACCATTCT\nTGCGAATGGAACCGCAAATGGATCGTATAACTTGGATTACATTAATGACCTTGTAAAAGAGTTTGGTATC\nCGTGTACAAGATGGTTCTAAAGGTGTATCAGAAGGATTCGGTGATTTATCAGAAGAGACACAAAAAGTAT\nGGGAATCATTCAATGAAGGTAAGGGAACCGCGGCTGCTGTATTTAATGCTGTATTAGGTGACTTACGTAA\nAATGGATGACAAAGTAAAGGCAAACCAGATTGGTGTTGCTCTATTCGGTACCAAATGGGAAGACATGGGG\nGCAGACGCCGTACTAAGTTTAAATGATGTGAATGGTGGTCTGGGTGATGTAAATGGCCGTATGGACGAAA\nTGAAAAAACTGCAAGAAGAATCACTGGGCCAAAAATTCCAGAGCGCATTAAGGGAAACTCAAACAGCACT\nTGAGCCTTTAGGAAAACAACTTGCGGATCTTGCAGCAGATGTTCTCCCTAAAGCTGCAAAAGGACTATCA\nGACCTTGCTGAATGGTTTTCCAAGTTACCAGAACCTGTCCGAAACTTTGTTGCTATTTCTGCCGGATTAA\nCGATTGCTATTACTGCAATTGGCGTTGCTATTGGTGTTTTAACTTTTGCAGTTGGTGCTTTGAATATTGC\nATTAGGACCTGTAATATTAGCGATTTTGGGAATTTCCGCCGCAATAACTATTGCTATAGCGATAGTGAAA\nAATTGGGGTGCTATAACCGATTGGCTTTCCGAAAAGTGGACCCAATTTAAAGATTGGTTTGGTGAATTGT\nGGTCTGGAATAGTTCAGGCTTGTAGTGATGGGTGGTCTTCCACAGTTGAGTACTTTTCCGAAGCCTGGTC\nGTCATTTATTGAAATGATGCATGAATTTTTTGACCCTATAGGTCAGTTTTTTAGTGAATTGTGGTCTGGA\nATTGTCGAAACAGCGTCATCTTGGTGGTCGAATCTTGTCACAACTGCATCAGAATTGTGGAGTCAACTGA\nCTCAAGCCTGGCAAGAAACTTGGAATACGATACTTACCGTCTTAGATCCAATTATTTCGGCGATATCTGT\nCGTTTTAGAAGCAGGTTGGTTATTAATACAGGCAGGTACACAAATTGCCTGGGCCTTAATAAGTAAATAT\nATTATTGATCCGATTACTGAAGCGTACAACTGGTGTAAAAATCAGTTCGGTGAGTTAGTTTCTTGGTTAA\nATTCACAGTGGGAAACGGTAAAATCTTATACACTTGCAGCGTGGAATTTGGTAAAACAGTATGTTATTCA\nACCGGTTCAAGAATTGTGGAATACAACAAAGCAAAAACTTGGAGATTTAGCTAATTGGATACTATCAAAT\nTGGGAATCTATAAAATCCTATACGCTTACGGCGTGGAATTTGGTGAAGAAATATGTGATTGATCCAGTAA\nCTGAAGCCTATAATTCAGCTAAGCAAAAATTTACTGATTTATATAATTCAGCGAAAGAAAAATTCGATTC\nTGTGAAGAATGCTGCACAAGAAAAATTTGATGCTGCTAAACGTAACATCATTGATCCAATAAAAGAAGCA\nGTTGGGAAGGTAGAAGAGTTTGTGGGTAAAATCAAAGGTTTCTTTGATAATTTGAAGCTGAAAATCCCTA\nAACCTGAAATGCCAAAGCTTCCACATTTCAGTCTGCAGACTAGTTCTAAAACAATTGCAGGTAAAGAAAT\nCTCTTATCCATCTGGCATAAATGTGGATTGGCGTGCTAAAGGCGGTATTTTCACACGGCCAACTATTTTC\nGGAATGAATGCTGGAAACTTACAAGGCGCAGGAGAAGCTGGACCGGAGGGGGTTCTACCCTTAAATGAAA\nAGACACTAGGTGCCATTGGAAAAGGAATTGCATCTACGATGACACAACAAAGTAATGACCGTCCAATTAT\nCCTACAAGTGGATGGAAGAACGTTTGCTCAAATCACCGGTGATTATACAGATCATGAAGGTGGAGTGAGA\nATTAGAAAAATCGAAAGGGGGCTGGCATAGATGCTATATGGAATTAATTTTAATGGAAAACATTCATATG\nACGATATGGGATACACTATGCCAGCTGATGGCAGAGATATTGGCTTTCCAAGTAAAGAGAAAATTGTTGT\nAAAAGTTCCTTTTAGTAATGTTGAATACGATTTTAGTGAAATATACGGATCTCAAACATATACTTCAAGA\nACATTGAAATACCAATTTAACGTTTTAAGGCAAGGGAATTTTACACCGCATGCAATGCAAATCGAAAAAA\nCAAAGTTAATTAATTGGCTTATGAATACTGGCGGAAGAAAAAAGCTTTATGATGATACTATTCCTGGTTA\nTTACTTTTTAGCTGAGGTAGAAAGTGCGGCTGATTTCCAAGATGATTGGGAAACGGGAACAATGACGGTA\nACTTTCAGAGCATATCCTTTTATGATTGCTGAATTGTATGAAGGTAATGATATATGGGATAGTTTTAACT\nTTGATTTGGATGTTGCGCAAACTACTAATTTCACTGTGAATGGTATGTTACAAATGGTTTTACTAAATGT\nAGGGGCTTCTGGTGTAGTTCCAGAGATAACAACATCTAAGCAAATGAAGATTATTAAAGATGGAGTCACC\nTATACTGTGTCAACAGGTATTACAAGAGATAAGAATTTTGTACTTAAATCAGGAGAAAATCCCATAAAAG\nTTACTGGTAATGGTACCATCTCATTCCGTTTCTATAAGGAGTTGATTTAAGTGTATAAAGTAACGATTAT\nTAATGATGGTATTGAAACAATAATTCATAGCCCCTATGTAAATGACCTTAAATTACCGTTTGGTGTAATA\nAAAAAAAGTATAAATCTAATAGATGCATTTAATTTTAGTTTTTATATGAATAATCCTGGTTTCCATAAGA\nTAAAGCCGTTAAAAACACTTGTAAATGTGTTAAATACAAAGACAGGTAAGTATGAATTTGAAGGGCGTGT\nGTTAGGTCCAAGTAAGAATATGGACAATTCAGGACTTCATAGTACTTCATATGAGTGTGAAGGTGAACTT\nGGGTATCTACATGATTCAGTTCAACGGCATTTAGAATTCCGTGGAACGCCAAAGGAACTTTTTGCAAAAA\nTTATTGAGTATCATAACAACCAAGTAGAGGAATATAAAAGATTTAAAATTGGAAATGTAACAATTACCAA\nTACTACAAATAACCTTTATCTTTATTTATCAGCGGAAAAAGATACTTTTGAAACAATTAAAGAAAAACTA\nATAGATAAATTAGGTGGCGAACTCCAAATACGTAAAGTAAACGGAGTTCGTTTTTTAGATTATTTAGAAC\nGTGTTGGTGAAGAGAAAAAAACAGAAATTCGAATCGCTAAAAATTTACTCAGTATGTCTTGCGACATAGA\nTCCGACTGAAATTATTACTCGCTTGACTCCTTTAGGTACACGAATAGAGTCAAAAAATGAAGGAGCGACA\nGATGCATCAGAAGCGCGATTAACTATTGAATCAGTTAACAATGGAGTACCTTATATTGATCATCCAAGTG\nGAATAAAAGAGTTTGGTATACAAGGTAAATCTATAACTTGGGACGATGTAACAATAGCAAGTAACTTACT\nTGCAAAAGGAAAAGAGTGGTTTGCAAATCAAAAATCAATTGTAACTCAATATAAACTAAGTGCAGTTGAT\nTTGTATTTAATTGGTCTAGACATCGATTACTTTGAAGTAGGGAATTCTCATCTAGTCATAAATCCTGTTA\nTGGGGATAGATGAGCTTCTAAGGATTGTTGGGAAATCCTTAGATATTAATAATCCACAAGGAGCCAGTTT\nAACAATTGGAGGTGCATTAAAAACATTAAATCAATATCAAAGTGATTTGAAAAAATCAGCACAGCAAGTT\nGTGGATTTACAATATACAGTGCTGAGACAAAACGGGAAAATCAATTCGTTGTCAGCCAGTCTTGTTGAAG\nCAGAAAAATTATTACAGTCCTTAAATGAAGCTGTTGAAAATGCGGATTTACAAATGATTGTTCAGTCAGT\nTTCTGATTTAAAAAGTGCTTTAAAAAAAATTGAAGAGGAAATACAAACTTTACCCACATCCGAAGTGATT\nTTGCAGATGCAAAAAGATATACAAAATAATACAACTGAAATTGTAGATATCGATGAAAGAATGATTGAAT\nCTGAAGTAGTAATTGAAAATAATAGTAAAAGCATTGAAGTATTACAAATCGATTTAAAAGATGTAGTAGA\nTCGTCTAACTGCTTTAGAAAATGGAGGTTCATAATGTGGCAAATATAAGTGGTTTTTTAAATAGAATTCG\nAACCGCTATTTATGGTAAAGATGTTCGTGAGTCTATACATGATGGGATAGAAGCTATCAATAAAGAGACA\nGAGATAGCGACGAAACTTTCCAATAATATAAAGATTAAACAAGTTGCTTTAGAAAAGAAATATGATGACC\nAAATTTCTAACATGACAAATGAAAATCCATCTATTAGTGAATTGGTTGATTTTAGAACTAGTGGATTTAC\nAGGAATGTCATATGTTACAGCGGGAAAAAGAACTGATGCTATTGATGAAAGGATTACAGATATGTCTGTC\nAGCATAAAAGACTTCGGAGCAGACCTCACAGGAGAGACAGACAGTACGGTAGCTATTCAACAAACAATAG\nACTACGTATATGATCGTGGAGGTGGTGTAGTTTATATTCCGCCAGGGATTTTAAGATACACTTCTATAAT\nTGTTAAAATTGGTGTTCATATTCGTGGTTCATTAGTTTCAATTACAGATTGGAATGGGAGGTTAGGCTCT\nAATACGTCCGTAACTACTTTGATACCAACTGATCTTAATAGACCTTCTATCATCATGCATGGGAACTCAA\nCGATTAATGGCGTCTGTTGGTTTTACGAAGGGCAAAAGAAAGAACTGACGTCTGAAAGTGACACATTTAT\nTCAATACCCTCCAACTATTCAGTTGGGTGATGCGTCAAACAAGGCTATTGGAAATTATATTGGAAACTTT\nATAGTAATTGGAGCATATGACTTCATATCGCAATACTCATTTTCAAATAGCGTAGAAAAGTTATTTGTAG\nAAAAAGGATATGGTATGTTCTTAAATACATTTTGTACGCTTAAAAAATGTACTGATATTCCTAGATTCTC\nTAAGATTCATATGAATCTAAATTCAGCATTAGGATGGCTAACTGGAAATACAGTTCCTTATTACTCTAAA\nATCGCTCGTAATGGTGTAATGTTTAAGGTTGCGCGTGTCGATGACTGTGTGATAGAAGATTGTTTTGCAT\nATGGCGTTAAGCACTTTGCTCATCTCTATAAAGAGGTGGGTGAGGATGGGAACGGCGGTGGTATAACAGT\nAATTGGATCAAGCTGTGATGTTTGCCATCAAGCGTTTAGAAACGATCGTGGAAATCTATCGTTTGGCGTG\nAAAGTAATCGGGGGATTTTTCACACCAGTTGTTAACGTGGATGGCAGCGAAAAATGTTTAATTTACCTTA\nGTCAAAACGCTACATATACTAGAATGCAATTTTCGTCATTCAAATGTTATGGAGATGTTGTATCACAGGT\nAAGTAATACTTCAAAAACAGACCATATTGTTATTTTCGAAAACGGAAATGCGGGTAATAACGTCGTAAAT\nTTATTTGGCGATGTACAGTTTAATATTGGTATTTCGAAAAACGAGAACGTGTTGATCAATAATGTTGTAA\nATTTTATTGGTACAGATAGGGATTCCTCTTTATCAAAACTAGATAGAGTGACTATCCGTCATCTTGTAAT\nGACCGGTTCTCGAATTGATCTAACTCATGGTGTCGATGATATTGCATGGTTTAAAGTGAATAATGAATAC\nGCTTTTGGTGCAGTTAAGGATGCCTATGATCCGACATTTTTTACAAAAGCGTATTTCCGACCAGGTACAC\nTGACTTCATTACCAACCGCAAATGCAAATCATCGTGGAAAGATGATTCGTCTGGAAGGTGCAAATGGTGT\nTGAGGATAGGTTATTTATATGTAAAAAGAAAAGCGATGGAACATATCACTGGAAACAGCTAGACGCAGAA\nCAATAATGATGAAGGGGTGTTTTAAATGGGATTGCAAGTTAATATAACTTTATTTAATCAATTAGAAGTA\nAATTCATATGCAAGAGTCGGCAATATTGGAGGAACAAAAGAGGAACAGTTTTTTTCTATTGATTACTACG\nCTTCGCGAAATGCCTTTTTGAGGAAACTTGACCCTATCAAACAAGAAAACTATAAATTCACTCCATCTGT\nTATGGATGACTCATTGAATTTTGTGAAACAAGCTTATATTTATGTTAAAAGAAGAACGGAATTTGCGGGT\nGCTGTCGATGTATTAGAAGAAGGGCAAAAATCTTGAGTTTAATAAAATTCCTCAGTTTATCTAATATATA\nAGATTTTATATGTTATTATATGTAATGGCGTCTTAATATAAGACGCTAATACATATAATTTGGAGGAAAA\nAGATGAACATATCCAGTCACCAAGAGGGAATGTCAAAACTGAATATAATAATACTACTTTTTCTCTCGTA\nTATAATGAGTACTTATAAATACGGGGAATTTGTACATTATTTTGTGTTTATAGTCATGGCCGCTCTTATA\nCTTAGAATGCTTACTGTAGGCATCAAGGTAAGTAATGAAATATCAATAAATAAAGGCATATTGACGTTTT\nGCGTAATTTTATTAGGGTTATTGTTATTGAAATCGATTTTTAACTTAAATGAATTAAAGGCATTTATTAA\nGAATTATTCAGTTATCTATTTCGTTCTAATTTACGGCCTTCTAGAATATTATAAGAATGGTGCTAGGTAT\nGGAGAGCAAGTTTTTATACAGCTTACTAAAATACTAAATGTACTTTCTGTCTTAAACCTAATTCAGGTTG\nTTTTACACAGACCGTTATTATCTGGATTCTTCACAGAACAGATGGACAAGTATCAATATTGGGCGTATGG\nTACTGGTGACTTTAGACCAGTTTCCGTGTTTGGTCACCCTATTGTAAGTGCATTGTTTTTTTCTATATTA\nGTGATCTGTAATCTTTATATACTTAAAGGCAATTTAAAATATCCATTGCAGATTGTGGCACTTGTGAATG\nTCTATGCCTCGCAATCTAGGAGTGCTTGGATTGCATTAGCAATTATTGTATGCTTGTATTTTATTAAAAA\nTTACCGTATTAAAAAAATAAAAAGAAATGTTCGATTTACTTATAGTCAATTATTAAAAATTTATGTTTCA\nTTAGTAATAGTGATCTGTGGATTTGGCTTAGTTGCTTTAAGCTCGGATAGTATCATAAGTTCCATAATTG\nAAAGATTCGGAGATTCTTTAAGTGGGAATAGTAAAGATATTTCAAACTTACAACGGACGGGCACATTAAG\nTTTAATTAATACTTATATGTTTCAACAAGATATGTTTAGATTACTGTTTGGTTATGGATTAGGGACTGTA\nGGAGATTTTATGTCTGTTAATACCGTTGTTATTCGTAATTTCTTGACGACAGATAATATGTATTTGACTT\nTTTTCTTTGAATTAGGGCTCTTGTCATTGATTAGTTATGGATTATTCTTTATTATTGGAGTCATTCGTTT\nTTTCTTATCTAAAAATTACTGGTTAAGCGAATTAGGCGCTTTATGTTTTATCTTTTTATCAATCATAATA\nTTTTTCTTTGAAGGTATAGGGTGGGGTACTGTAGTAACTGTTTGGATGTTTTCTTTACTGACCATTCTAA\nTGAAATTTAAAAATCCAAACAGTTTAACAAAAAATAAAATAAAATAGTTACAGTAGTATTTATACTAGTT\nTTTGGGAGAGAAACATGAACAAAAAACAATTAAAAGAAACAATTAATTCAGACTTATACAGAGTATACGG\nAAGTCAAGGAACAAAAAAGAAAATTATTAATTTCTTAAGAAACCCTGGCTTTAAATATTTATATATACTA\nCGTAAATGTAGTTATTATAAAGAGAAAAACAAGTTAATGTATAGATTGTATTTTATATTATTGTTGCGTT\nATCAGTATAAGTATGGACTAGAAATAATGCCTGATACGAAGATTGGAAAAGGCTTTTACATTGGACATAT\nAGGAGCTATTACAATTAATCCTAAATCTATAATTGGTGAAAATGTAAATATATTAAAAGGGGCATTACTT\nGGCTATAATCCGCGAGGGAAATATAAAGGCTGTCCAACTATAGGAGATGGTGTTTGGATAGGTCCTAATG\nCTGTAATAGTTGGTAATATTACAGTTGGAAATAATGTAGTGGTAGCGCCAAATACGTTAGTCAATAGGGA\nTGTTCCAAGTAATTCAGTTGTGGTAGGTAATCCGTGTCAAATTATTTCACAGGATAATGCAACTGAAGCT\nTATGTCAATTATACAGTTTAACAAAATACAATTTTAGTTGAAAAGGAGACGAGTTATCGTCTTCTTTTTT\nTATTGTCAAAAGGAGATGAGAACAGTGGAAGATGCAATTTTCAATTCAGTCATTCAACAGGGCGCATTCG\nCAGCGTTATTTGTGTGGATGCTATTTACTACACAAAAAAAGAACGAGCAGCGTGAGGAAAAGTATCAACA\nAGTAATTGATAGAAACCAACAAGTAATTGAAGAACAGGCAAAAGCCTTTGGATCTATTTCTAAGGATGTA\nACAGAAATTAAACAAAAATTATTTGAAGGAGATGTTCAATAATGGGATATATCGTTGATATTTCAAAATG\nGAATGGCAATATTAATTGGGATGTAGCTGCAGCGCAATTAGATTTAGTAATTGCTAGGGTACAAGATGGT\nTCAAATGTTGTGGATCATATGTATCAAAGTTATGTGAGTGAAATGAAAAGGCGTGGTGTTCCTTTTGGTA\nATTATGCGTTTTGTCGTTTCGTTTCTGAAAATGATGCAAGAGTTGAAGCGAGGGACTTCTGGAACCGCGG\nTGATAAAGATGCATTATTCTGGGTTGCTGATGTGGAAGTAAAAACAATGGGGAATATGTTAGCCGGAACA\nTTAGCTTTTATCGATGAGTTACGTCGATTAGGTGCTAAAAAGGTTGGTTTATATGTTGGCCATCATACAT\nATAAAGAGTTCCAAGCTGATAAAGTAAACGCTGATTTTGTATGGATTCCTCGATATGGTGGGAATAGACC\nAGCTTATCCATGTGATATCTGGCAATACACAGAGACAGGAAATGTACCTGGTATCGGTAAATGCGATTTA\nAATGAGTTAATTGGTGATAAATCGTTATCTTGGTTTACCAATAATCACATGGGCTTAGTTGTTCCTGAGG\nTAGGAAAGCGAGTTGTTTCTAAAGTAGAGACTCTTAGATTTTATTCAAAACCTTCCTGGGCGGATGTGGA\nTGTTGCTGGAACAGTTTCTAATGGTTTGGGGTTCGCTATCATTGGAAGAGTCGATGTGAATGGTTCGCCA\nCAATATAAAGTACAAAATTCTCGTGGTAGTGTCTTTTATATTACGGCTAGTCCAAAATATGTAGAAGTAA\nAATAAAAATTGCCGGCTCTTAATTGATATGCTCCCCCTATAGTAGACAGAAAAAAGAAAGCTTTATATCC\nTGTCTACTATAAGGGGGATTTTTTTATGGGGAAAATTAGAAGAACATATGATGAAACATTTAAGAAAAAG\nGCTATAGATTTATATTTTAAAGAAGGCATGGGTTATACCCAAATAGGAAAAACACTAAGCATTGATGAAA\nAAAACGTACGTAGATGGGTAAAACGTTTCAAAGAAGAGGGTATCAAAGGCTTAGAAGAGAAACGTGGAAA\nGGCTACTGGAGGAACAAAGGGGCGACCTAAAAATTGTCCAAAGGAGCCTACAGAAAGAATCAAATATTTA\nGAAACAGAGAATGAAATGCTAAAAAAGCTATTGGGAATGTTAAAGGAGGGATGAAAGCTGCACCAGCATA\nCAAAAAATATGAAATCATACAAGAAATGTCCAAAGGTATGCGTTCAATACAGCTACTGTGTAAAATCGCG\nGAAGTATCTAGAAGCGGATATTACAAGTGGTTAAAAAGGCAAAGCAATCCTTCTCCGAAGGAGATAGAAG\nATGAAAAAATAAAGAATAAAATTTTGGAATGTTATAACCAAGTGAAGGGTATCTACGGATACCGAAGAAT\nAACTGTGTGGTTAAAGATGAAACATGGGATCGTCGTAAACCACAAGAGAGTTCAACGACTAATGAATAGG\nATGAAACTTAAAGCAATTATCAGAAAAAAACGACCTTATTTTGTATCAAAAGAAGCATATGTAGTCTCAA\nAGAATTACTTGAATCGAGATTTTAAAGCGGAACAACCAAATGAAAAATGGGTAACAGATATTACTTACCT\nTATTTTTAATGGGAAAAAGCTATATCTATCCGCCATAAAGGACCTTTATAACAATGAAATTGTAGCTTAT\nCATATTAGCCATCGTCATGATATACAACTAGTTATCGATACGCTAAACAAGGCGAAAAAACAACGAAACG\nTGCAAGGGATTCTTTTGCATAGTGATCAAGGTTTCCAATACACTTCACGCCAATATAATGATTTCCTAAA\nAAAACATAAGATGAAAGCTAGTATGTCTAGAAAGGCGAATTGTTGGGACAATGCTTGTATGGAGAATTTC\nTTTAGTCATTTCAAAGCGGAGTGTTTTAATCTGAGTTCATTTCGTTCAGTAGAAGAAGTTAAATTTGCCG\nTACATAAGTATATTCATTTTTATAACCACCATCGTTTTCAGAAAAAATTAAAGAACCTGAGTCCATACGA\nATATCGAACTCAGGCTTCTTAACTATGCGTTTTAATTACTGTCTACTTGACAGGGGTCAGTACATAATTG\nAGTCGGCTTTTTTATTGCAAATCAGATATCCTTCTAACTTGTTTTTCTTTCTTCTTGAAGTTCTTCTTGT\nACTGTTTAAATTCTTCTTTATCTACGTGGAACTTTTCTCCGGTGGCAACGTTTTTAACTAAGTATGTTTT\nGGTTGTAAGAGATTTAATTATGTAATAAATAGCAAATAGCATAAGAGAAATACAAAAGGTAGGAATAGAA\nAATACAATAGCAAGTGCAGCTAGTATATTATCTCTCTTATGATCTCTTTGTAACACTAAACGTTTCCCTG\nCTGCAGCTTGAGCTTGTTCTAATTGTTGCATACGTTGTAGCGATGCTACAGTATCATAACTCATGAAAAA\nACCTCCTTGAAATAATACCTAAATCATACCAATTTCATGTAACAACTGTAAATGTTAGTTTCTCATTTAT\nTGACAAAACAGAACAATTGTTCTACAATTCATTTACAAACAAATGTTCTTGAAAGGGGAAATTCATATGG\nCAGCAACTGAAAATACAACTAAAGGAAAAGAGAAAGCATTAGAAGAGGCTCTGAAGAAAATCGTAAAAGA\nATTTGGTACAGGGGCTATTATGAAACTGGGTGAGCGTCCTAATCAAAAAGTATCTGTCGTATCAAGTGGT\nTCTGTTGGATTAGATAATGCTTTAGGGGTTGGTGGATATCCAAAAGGACGCATTACTGAAATCTTTGGTC\nCTGAATCTTCAGGTAAGACAACTATAGCATTACATGCAATTGCAGAAGCGCAAAAAGAAGGTGGAACAGC\nGGCATTTATTGATGCAGAGCATGCACTTGACCCTATTTATGCACAGAAGTTAGGTGTTAATATTGATGAA\nCTGCTCATGTCACAACCAGATACAGGAGAGCAAGCACTAGAGATTGCAGAAGCTCTAGTTAGAAGTGGGG\nCTGTAGATATCATTGTGATAGATTCTGTAGCTGCTCTAGTCCCGAAAGCGGAAATTGATGGGGACATGGG\nAGATTCACATGTGGGATTGCAGGCTAGATTGATGGGGCAGGCAATGAGAAAAATATCAGGAGCAATATCC\nAAAAATGGAGTTGTAGCAATCTTTTTAAATCAAATCAGAGAAAAAGTTGGTGTTTCTTTTGGGAGTCCTG\nAGACAACACCGGGTGGTAGGGCGTTAAAATTCTATTCAACAATTCGACTAGATGTACGTCGAGGAGAACA\nGTTGAAAGGAAAAGAAAGTGACGTTTTAGGGAATAAAACAAAAGTGAAAGTAGTAAAAAATAAAGTTGCT\nCCACCATTTAAAAACATTGACTTTGACATCTTATACGGAGAAGGGATTTCCCTAGAGGGAGAGCTTATTG\nATATTGGGGTAGAGTTAGATATTGTTCAGAAAAGTGGTGCATGGTACTCGTATCAAGAAGAACGTCTTGG\nGCAGGGTAGAGATAATGCCAAGCAATTTCTGAAAGAGAATGAAAACATACGTAATTCTGTTCGAAATAAA\nATTTATGAATACTATTCTCCAAAAGAAGACTCTGTTGTTGTAAAAGCGGAGCTTATAAAAGAAAATGAGC\nCCATCACTTTAAAAGAATCTGAATAAGGTTATATAAAGAGAATCTTAAAATAAAATTCATGCTATGTATA\nTTTTAAAAACTGGAACACCTAGTTATTAGAACTGGGTGTTTTTATATACTCATAAACTCACGATCAAAAT\nAAAGCTTATCCATTAAGTTTTTTGTATATTATTTTGCAAGTAAGTTCCGTACATATTTACCCAACTGTTC\nATCTGTTAAACCTGACTTAATTGCACCTTTAATAGCATCAATTGTATTAATTGTATGAGGTTCATTCTCT\nTCTTTCTTTTTACTATGTATCCATTTCTTATATAGTTCATCCTCTTTCTTTGCCAAACTCAAAGCGTTCT\nCAACAGTAGTAACTTTCTTCCTCACCCAATGACCAGCTATTTTTTTGACATACTCAGGATTCAATATCAT\nGTCTGATCTCAGCATCACATAATAAATCAAAACATTTATAACAGGGTTAGGCAACCTATAATTATCACGC\nATATCAGTAACTATATGCAAATCCCCTTTTGGAACAGTAGCACCGCCTGATAACTCGCTTAAAAGTTGTT\nCAGGTGTAACAGAATTTAATTGCTGTATCAATTTTTGTTGTTTTTCCATGAATTTATCCTCCTAATACTT\nTGTATAATATAAATTTTATCTAGTAATCTTCCGCATTTAATATAACCCCATTTCATCAGATTCTTCTTTA\nGATAGTTTGTAATATATACTTGGTGCAAGAGGGTTATCTATTGTATTTGTGGAGGGGGTTTTTGAGTCAT\nTATCTTCTAACCAATTATAATATACACTACTAGTATCTGTGTTAGTTTTACGTTTAGAAATATTGTGGAT\nGTCTCTAAATCTATCGATGTAGTCATATACCATACTTTTAAATGTATTAGTAAAGTATCCAATTGGATTT\nTTCATAAGCTCTCCATTGTGTTCAACTTCATGAGTTTTAGAGAATAAAGTAACAGATGCATTCGCAAGGA\nTATTGTTAAATACATCCTTGTCAGATAGTAAACTAAACTTCTTAGCAGCCTTTTTAGCGATATTTACAGC\nATTGTGGAAGGATTCGTTAATAACTTTTGAACCAAATGCAGTTGCTAATTTCATACGCATAGATTGTGGA\nACACGATAGTCGATAAAATCATTATCATTGACTGTAGATTGAAACTCATTTCTATTACGTATATTTATAT\nTTTTTATATTTTGTTTTAAGGTTTTAGTAGTTGTTTTATTGGTGTGACATTTTTCTTCATTTTTAATAGG\nTGCTTGTGTGACAACCTGTTCCTCCACAATAATTGGTTGAATAACAATCGCATTGCATGTTTGCCTCATA\nTCGCTTTTACGCTTCATTTCTAGTTGTTTAATAATACCTAAAGACTCTAAGTGTAGGCATACTCTAATAA\nCCGTTCTACGGCTAATATTGAGGTCTTCAGCGATGTGTTTTTTTGTTCTGAATGATACACCAAAGAACTT\nAGAAGAATAGTTGTGTAATTTATTTAATACAGCCAATTGAGTTTTATTTAACTGATCTACGAATTTTTCT\nTTGTATGCACGAACAGTCTTGTTTAATTCATCGACTGTTTTAAATGTTGCTAGGTTTTCATATGTTTCAT\nTACCTGCAATAATTGTAATTCCTTGTTTCTTTTCCATAACGGTTTGTCTCCTTTTTGGAAACAAAAAAGC\nAACAGAATGCCAAGTGTAAGCAAACTGTTGCTAAGGAGCCCTTACGTACTGTAAAATAGTTCGTAAGAGT\nACAGCAAGTGTTTGCCTAGTGTGATTAGGCGGACGGTATATAGAGTGTTGACGCACTTTATATACACGCT\n\n"class(her1410_1)[1] "character"dim(her1410_1)NULLlength(her1410_1)[1] 1write(her1410_1,file="her1410_1.fasta")
seq1 <- read.fasta("her1410_1.fasta")As you can see, you can very easily download the data from any NCBI database. Regarding sequences, the main drawback of the function entrez_fetch() is that the downloaded sequences are character objects and transform it into sequences that you can handle with seqinr or other packages is not always straightforward and it requires some polishing (see ref. 7). Alternatively, you can save the data as a new fasta file in your computer before importing with seqinr, as in the following example.
# compare two files
her1410_2 <- entrez_fetch(db="nuccore", id=her1410$ids[2], rettype="fasta")
write(her1410_2,file="her1410_2.fasta")
seq2 <- read.fasta("her1410_2.fasta")

#codon frequencies
freq1 <- count(unlist(seq1),3, freq=TRUE)
freq2 <- count(unlist(seq2),3, freq=TRUE)

stop1 <- freq1[which(names(freq1)=="tga"| names(freq1)== "tag" | names(freq1)== "taa")]
stop2 <- freq2[which(names(freq2)=="tga"| names(freq2)== "tag" | names(freq2)== "taa")]
stops <- rbind(stop1,stop2)
stops <-  as.data.frame(stops)
stops$sequences <- c(her1410$ids[1],her1410$ids[2])
stops <- cbind(stops$sequences,stack(stops[,1:3]))
names(stops) <- c("sequences","freqs","stop_codon")
#plot
library(ggplot2)
p <- ggplot(data=stops) + geom_bar(aes(x=toupper(stop_codon),y=freqs,col=sequences,fill=sequences),stat="identity",position="dodge",alpha=0.8)
p + scale_fill_brewer(palette = "Dark2") + scale_color_brewer(palette = "Dark2") + theme_linedraw() + ylab("Codon frequency") + xlab("Stop codon") +  guides(color="none", fill=guide_legend(title="HER1410 sequences"))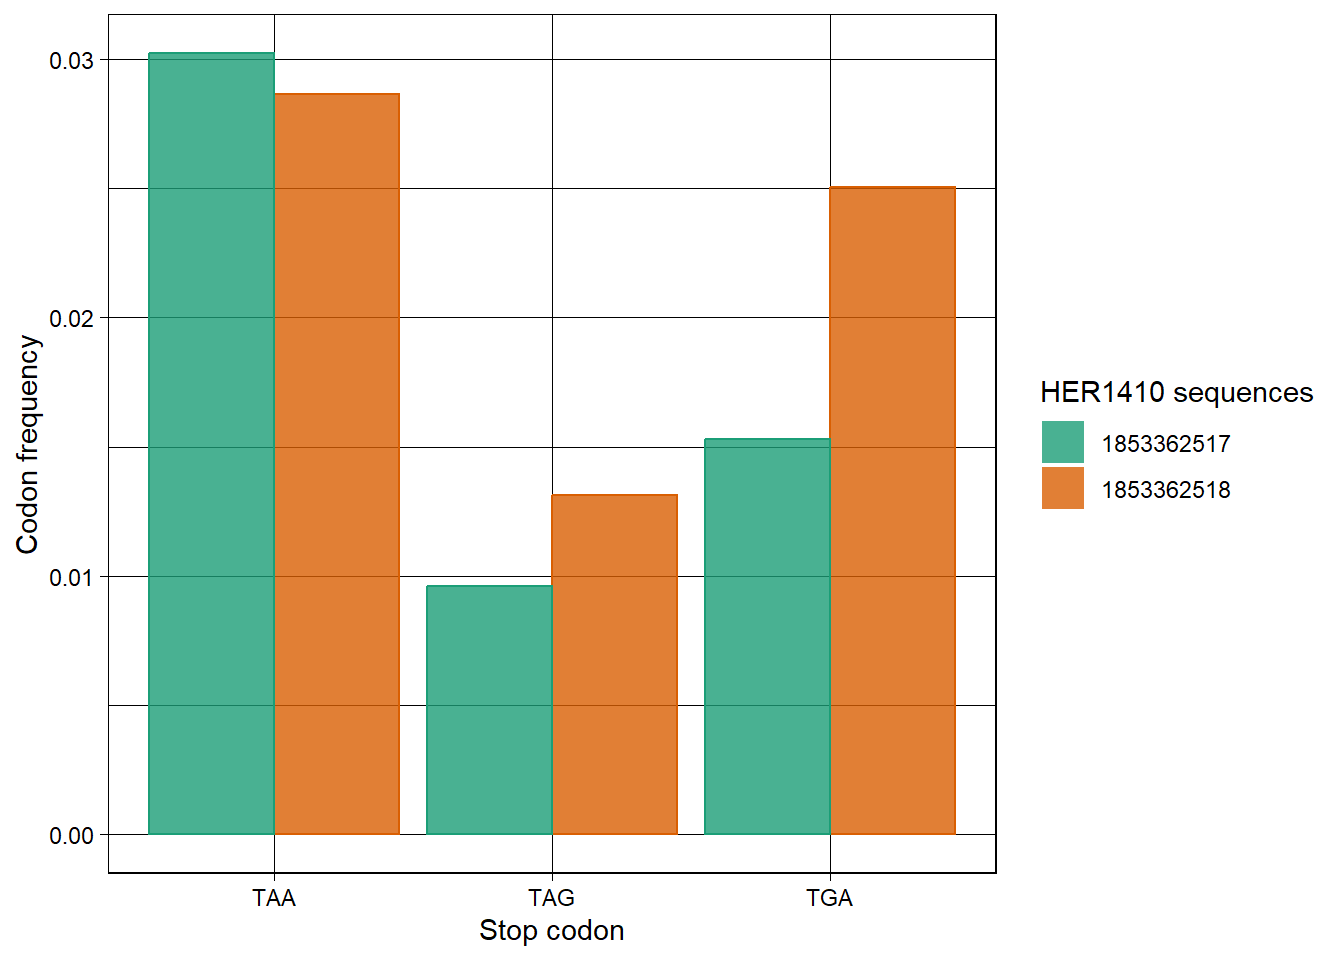
ggseqlogoR is very useful for many applications in Biochemistry and Molecular Biology, and ggplot2 is a very good example of that. Sequence logos are a compact way to visualise how frequent each nucleotide or amino acid is at each position of an alignment or motif.
#script by Luis del Peso
Counts<-matrix(c(2,38,0,0,0,0,10,8,4,7,21,9,9,11,9,23,4,15,10,0,46,0,0,0,32,17,
                 10,15,11,18,9,16,23,11,20,8,10,8,0,46,0,46,2,17,21,13,14,15,
                 27,8,13,8,16,22,24,0,0,0,46,0,2,4,11,11,0,4,1,11,1,4,6,1),
               nrow=4,byrow = T,
               dimnames=list(Nucleotide=c("A","C","G","T"),Pos=1:18))
counts <- data.frame(Counts)
names(counts) <- 1:18
counts <- cbind(stack(counts),c("A","C","G","T"))
colnames(counts) <- c("values","pos","nucleotide")
ggplot(counts, aes(x=pos, y=values, fill=nucleotide)) +
    geom_bar(position="stack", stat="identity")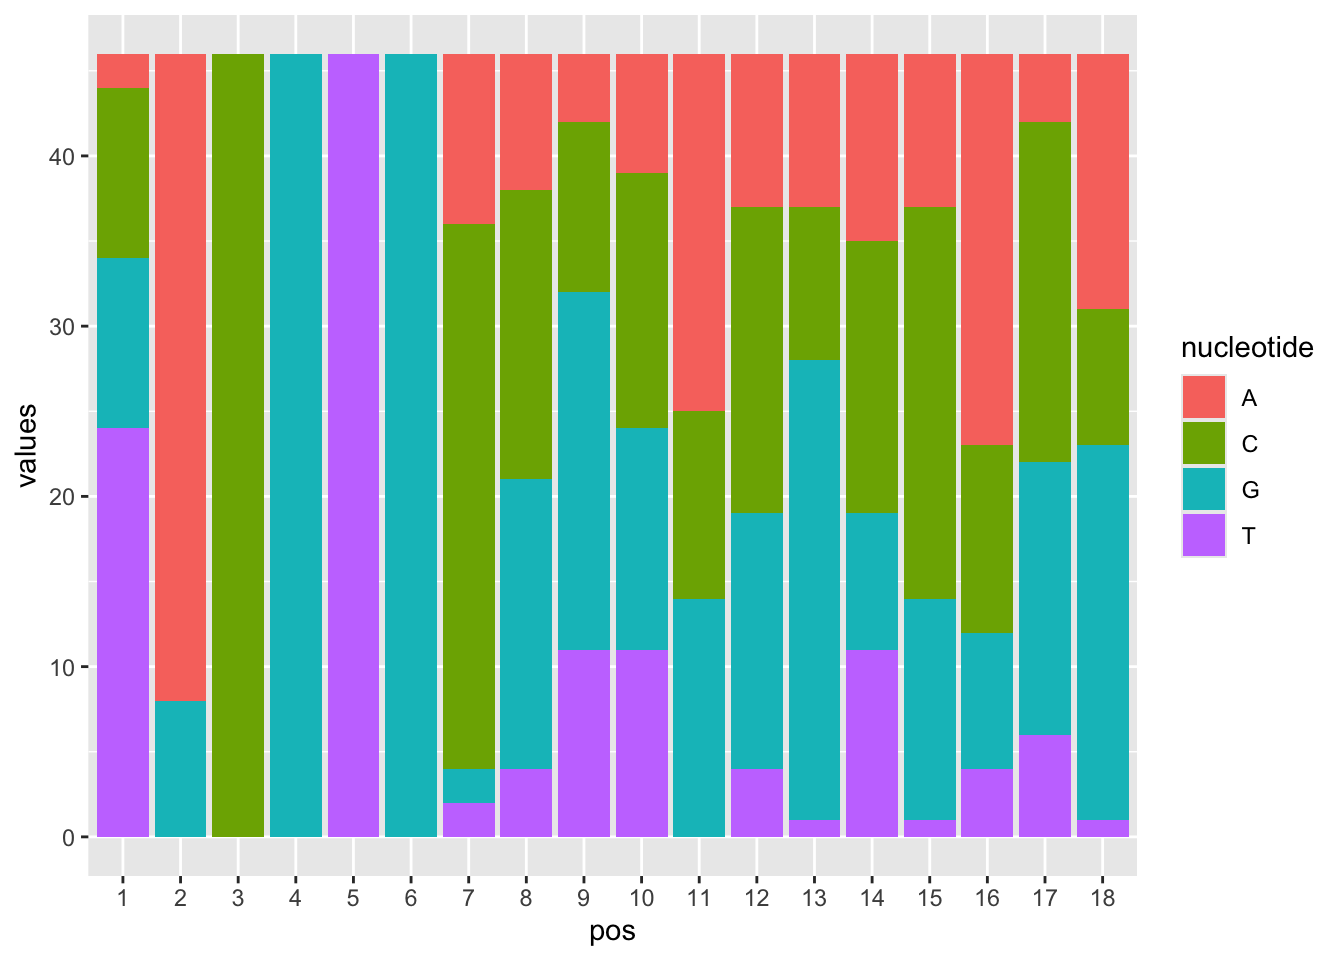
This is not a very interesting plot. Now, in order to plot the PSSM as a sequence logo, we are going to use the package ggseqlogo. Also, to arrange plot, we will use the package gridExtra, which is very handy and commonly used to generate complex figures.
if(!require(ggseqlogo)) install.packages("ggseqlogo", repos = "https://cran.rstudio.com/", dependencies = TRUE)Cargando paquete requerido: ggseqlogoWarning: package 'ggseqlogo' was built under R version 4.6.1library(ggseqlogo)
ggseqlogo(Counts) Warning: The `<scale>` argument of `guides()` cannot be `FALSE`. Use "none" instead as
of ggplot2 3.3.4.
ℹ The deprecated feature was likely used in the ggseqlogo package.
Please report the issue at <https://github.com/omarwagih/ggseqlogo/issues>.Warning: `aes_string()` was deprecated in ggplot2 3.0.0.
ℹ Please use tidy evaluation idioms with `aes()`.
ℹ See also `vignette("ggplot2-in-packages")` for more information.
ℹ The deprecated feature was likely used in the ggseqlogo package.
Please report the issue at <https://github.com/omarwagih/ggseqlogo/issues>.
#install.packages("gridExtra")
p1 <- ggseqlogo(Counts, method="prob")
p2 <- ggseqlogo(Counts, method="bits")
gridExtra::grid.arrange(p1, p2)
Let’s plot some protein logo from the example sequences in the package. Remember that we are working with an add-ons to ggplot. That means that all ggplot elements can be used.
data(ggseqlogo_sample)
str(seqs_aa)
List of 4
$ AKT1 : chr [1:172] "VVGARRSSWRVVSSI" "GPRSRSRSRDRRRKE" "LLCLRRSSLKAYGNG" "TERPRPNTFIIRCLQ" ...
$ CDK2 : chr [1:444] "LGPYEAVTPLTKAAD" "SGSESGYTTPKKRKA" "GSESGYTTPKKRKAR" "VTTQTPLTPEQLRAV" ...
$ AURKB : chr [1:106] "ITVTRRVTAYTVDVT" "PWPYGRQTAPSGLST" "APSLRRKTMCGTLDY" "PSKKRTQSIQGKGKG" ...
$ CSNK2A2: chr [1:80] "KHEEEEWTDDDLVES" "VWDHIEVSDDEDETH" "TSADVKMSSSEEVSW" "SADVKMSSSEEVSWI" ...head(seqs_aa)$AKT1
[1] "VVGARRSSWRVVSSI" "GPRSRSRSRDRRRKE" "LLCLRRSSLKAYGNG" "TERPRPNTFIIRCLQ"
[5] "LSRERVFSEDRARFY" "PSTSRRFSPPSSSLQ" "GRSGRGKSFTLTITV" "SGRGKSFTLTITVFT"
[9] "SGRAREASGAPTSSK" "CVRMRHLSQEFGWLQ" "GTRGRLESAQATFQA" "ARRARSKSLVMGEQS"
[13] "QFRRRAHTFSHPPSS" "ATRGRGSSVGGGSRR" "ATRKRRWSAPESRKL" "PFRGRSRSAPPNLWA"
[17] "FIFMRRSSLLSRSSS" "GQRDRSSSAPNVHIN" "PQRERKSSSSSEDRN" "LKRKRRPTSGLHPED"
[21] "QTSKRHDSDTFPELK" "RFRDRSFSEGGERLL" "TRRTRTFSATVRASQ" "KLRRRFSSLHFMVEV"
[25] "GSRVRVDSTAKVAEI" "SRRPRRRTFPGVASR" "LKKIRLDTETEGVPS" "GQVPRTWSEKDLREL"
[29] "SIRPRPGSLRSKPEP" "THLSRVRSLDLDDWP" "LLRDTFTSLGYEVQK" "AKRPRVTSGGVSESP"
[33] "HKRRRSRSWSSSSDR" "RRRRRSRTFSRSSSQ" "DHWIRMRSQEGRPVQ" "EDQPRCQSLDSALLE"
[37] "QDTQRRTSMGGTQQQ" "LGGGRVKTWKRRWFI" "RTPRRSKSDGEAKPE" "SFRRRHNSWSSSSRH"
[41] "RTRSRRLTFRKNISK" "SYKIRFNSISCSDPL" "TSRIRTQSFSLQERQ" "RVSIRLPSTSGSEGV"
[45] "GGRERLASTNDKGSM" "IKRSKKNSLALSLTA" "CWRKRVKSEYMRLRQ" "ASPARRASAILPGVL"
[49] "CLRSRDPSLMVDFIL" "GLETRRLSLPSSKAK" "LGRERLGSFGSITRQ" "KTYRRSYTHAKPPYS"
[53] "KLRRRSTTSRAKLAF" "LPRPRSCTWPLPRPE" "SPRRRAASMDNNSKF" "TFRPRTSSNASTISG"
[57] "QSRPRSCTWPLQRPE" "APRRRAVSMDNSNKY" "QSRPRSCTWPLPRPE" "APRRRAASMDSSSKL"
[61] "TFRPRSSSNASSVST" "LLRERKSSAPSHSSQ" "QTRNRKASGKGKKKR" "QTRNRKMSNKSKKSK"
[65] "INRERQKSLTLTPTR" "ANLNRSTSVPENPKS" "SGRARTSSFAEPGGG" "SGRPRTTSFAESCKP"
[69] "RKRSRKESYSIYVYK" "LYRSRMNSLEMTPAV" "SQRGRSGSGNFGGGR" "RALSRQLSSGVSEIR"
[73] "RVRVRLLSGDTYEAV" "GGRSRSGSIVELIAG" "EMRERLGTGGFGNVC" "VPSGRKGSGDYMPMS"
--- Cropped output ---ggseqlogo(seqs_aa, ncol=4)
ggseqlogo(seqs_aa, ncol=2) + theme_light()
There are two other ggplot-based packages that I find very interesting for sequence-based plots:
ggmsa allows visualization and annotation of multiple sequence alignments.Check out vignette and examples here: http://yulab-smu.top/ggmsa/
drawproteins is very useful to represent and compare protein domains and catalytic residues.See the vignette and some example here: https://rforbiochemists.blogspot.com/
Bioconductor is a repository of R packages for “the analysis and comprehension of high-throughput genomic data”. It started 2002 as a platform for understanding analysis of microarray data, being the first R version 1996, and the first stable beta in 2000. For example, release 3.16 included 2183 packages on November 2, 2022, covering diverse bioinformatics tasks. It also contains many learning resources, spanning vignettes, course materials, and workflows.
The diversity of packages in Bioconductor allows working with widely used bioinformatics apps and file formats (fasta, fastq, BAM, SAM, vcf…), for different stages of sequence analysis, quantification, annotation… You can explore packages by categories on the Bioconductor site.
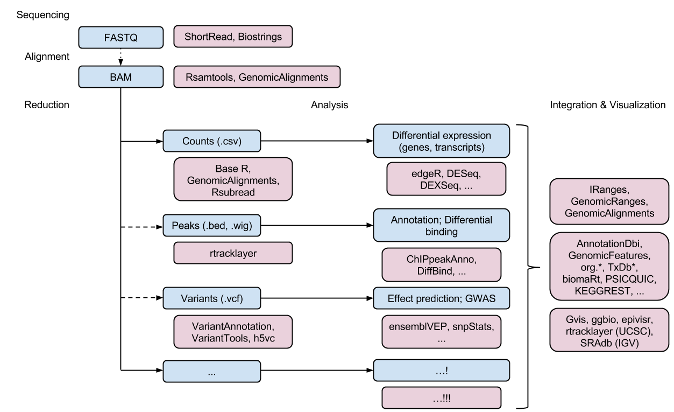
Some of the most common Bioconductor packages and functions are:
GenomicRanges: ‘Ranges’ to describe data and annotation; GRanges(), GRangesList()
Biostrings: DNA and other sequences, DNAStringSet()
GenomicAlignments: Aligned reads; GAlignments() and friends
GenomicFeatures, AnnotationDbi: annotation resources, TxDb, and org packages.
SummarizedExperiment: coordinating experimental data
rtracklayer: import Genome annotations e.g BED, WIG, GTF, etc.
Annotationhub: access to Ensembl, UCSC, NCBI and other databases.
I recommend you to check the examples in the reference 9 below and other workflows that you can find at Bioconductor.
sessionInfo()R version 4.6.0 (2026-04-24 ucrt)
Platform: x86_64-w64-mingw32/x64
Running under: Windows 11 x64 (build 26200)
Matrix products: default
LAPACK version 3.12.1
locale:
[1] LC_COLLATE=Spanish_Spain.utf8 LC_CTYPE=Spanish_Spain.utf8
[3] LC_MONETARY=Spanish_Spain.utf8 LC_NUMERIC=C
[5] LC_TIME=Spanish_Spain.utf8
time zone: Europe/Madrid
tzcode source: internal
attached base packages:
[1] stats graphics grDevices utils datasets methods base
other attached packages:
[1] ggseqlogo_0.2.2 ggplot2_4.0.3 rentrez_1.2.4 RColorBrewer_1.1-3
[5] seqinr_4.2-44 webexercises_1.1.0 formatR_1.14 knitr_1.51
loaded via a namespace (and not attached):
[1] ade4_1.7-24 gtable_0.3.6 jsonlite_2.0.0 dplyr_1.2.1
[5] compiler_4.6.0 tidyselect_1.2.1 Rcpp_1.1.1-1.1 gridExtra_2.3
[9] scales_1.4.0 yaml_2.3.12 fastmap_1.2.0 R6_2.6.1
[13] labeling_0.4.3 generics_0.1.4 curl_7.1.0 htmlwidgets_1.6.4
[17] MASS_7.3-65 XML_3.99-0.23 tibble_3.3.1 pillar_1.11.1
[21] rlang_1.2.0 xfun_0.57 S7_0.2.2 otel_0.2.0
[25] cli_3.6.6 withr_3.0.2 magrittr_2.0.5 digest_0.6.39
[29] grid_4.6.0 rstudioapi_0.19.0 lifecycle_1.0.5 vctrs_0.7.3
[33] evaluate_1.0.5 glue_1.8.1 farver_2.1.2 rmarkdown_2.31
[37] httr_1.4.8 pkgconfig_2.0.3 tools_4.6.0 htmltools_0.5.9 R in action. Robert I. Kabacoff. March 2022 ISBN 9781617296055
Regular expressions in R: https://rstudio-pubs-static.s3.amazonaws.com/74603_76cd14d5983f47408fdf0b323550b846.html
R Programming for Data Science (Chapter 17): https://bookdown.org/rdpeng/rprogdatascience/
A little book of R for bioinformatics: https://a-little-book-of-r-for-bioinformatics.readthedocs.io/en/latest/index.html
rentrez vignette: https://cran.r-project.org/web/packages/rentrez/vignettes/rentrez_tutorial.html
Biostrings: https://kasperdanielhansen.github.io/genbioconductor/html/Biostrings.html
Example of the generation of multiple sequence alignments and phylogenies with R: https://rpubs.com/bhuvic/828540
Where do I start using Bioconductor: http://lcolladotor.github.io/2014/10/16/startbioc/#.Y4ZCaOyZP0p
Bioconductor Workflow: Introduction to Bioconductor for Sequence Data: https://www.bioconductor.org/packages/release/workflows/vignettes/sequencing/inst/doc/sequencing.html
A useful sequence-analysis workflow is: